سير عمل Google ADK 2.0: اختبار عمليات إعادة المحاولة والمهل الزمنية (2026)
٢٩ سبتمبر ٢٠٢٦
ملخص: قمت بتشغيل محرك الرسم البياني Workflow في google-adk 2.10.0 باستخدام عقد وظائف Python بسيطة (بدون استدعاءات LLM) على إصدارات Python 3.10 و 3.11 و 3.12 و 3.13، وهناك ثلاث نتائج تستحق المعرفة. أولاً، يقوم RetryConfig() المجرد بإجراء ما يصل إلى 5 محاولات، ولكن قيمة الـ jitter الافتراضية هي 100% كاملة، لذا فإن كل فترة انتظار تكون عشوائية: في دفعة واحدة مكونة من 20 عملية تشغيل على Python 3.11.15، تراوح الوقت من بداية المحاولة الأولى إلى بداية المحاولة الخامسة من 6.6 ثانية إلى 25.4 ثانية، وليس 15 ثانية ثابتة. ثانياً، لا يمكن لـ timeout الخاص بالعقدة مقاطعة الكود الذي يتسبب في حظر (blocking code): مع timeout=0.3، كل عقدة توقفت لمدة 1.0 ثانية استمرت في العمل للثانية كاملة، وسواء اكتمل التشغيل بعد ذلك أو فشل بـ NodeTimeoutError، فقد اعتمد ذلك على ما فعلته العقدة تالياً وعلى إصدار Python (العقدة التي أعادت قيمة مباشرة بعد الحظر اكتملت في 3.10 و 3.11 وفشلت في 3.12 و 3.13). ثالثاً، قيمة المسار (route) التي لا تطابق أيًا من الحواف الموجهة للموجه (router) لا تثير أي خطأ: عندما تم توجيه جميع حواف الموجه، انتهى الفرع بتحذير واحد في سجل ADK، وعندما كان لديه أيضاً حافة غير موجهة، عملت عقدة تلك الحافة ولم يتم تسجيل أي شيء.
Google ADK 2.0 Workflow: الإجابة المختصرة
الـ Workflow في مجموعة تطوير الوكلاء (ADK) 2.0 من Google هو عبارة عن رسم بياني من العقد المرتبطة بقائمة edges. يمكن أن تكون العقد وظائف Python، أو وكلاء، أو سير عمل متداخل، ويتبع المحرك الرسم البياني الذي تحدده بدلاً من ترك التسلسل للمطالبة (prompt). يمكنك إرفاق RetryConfig و timeout بعقدة، واختيار فرع باستخدام Event(route=...)، وتوزيع المهام (fan out) ودمجها، والتوقف لانتظار تدخل بشري باستخدام RequestInput. تم إجراء الفحوصات أدناه على حزمة Python، google-adk 2.10.0. التواريخ والاقتباسات مأخوذة من المصادر المرتبطة، والبيانات المتعلقة بالتفاصيل الداخلية لـ ADK مصنفة كقراءات من مصدر الحزمة. لم أقم باختبار SDKs الخاصة بـ Go أو TypeScript.
ما ستتعلمه
- ما هو الـ
Workflowالقائم على الرسم البياني في ADK 2.0 وأي إصدار يتضمنه - ماذا تفعل سياسة إعادة المحاولة الافتراضية، وكيف يغير الـ jitter الافتراضي التوقيت
- كيف يحدد
RetryConfig(exceptions=...)نطاق إعادة المحاولات، وماذا يحدث في حالة عدم وجودretry_config - لماذا لا يمكن لـ
timeoutالخاص بالعقدة مقاطعة الكود الذي يتسبب في حظر، وكيف تتغير النتيجة بناءً على ما تفعله العقدة تالياً وإصدار Python - ماذا يحدث عندما لا يطابق المسار أي شيء، وكيف يقوم
DEFAULT_ROUTEبالتقاط ذلك - لماذا يعمل توزيع المهام (fan-out) بالتوازي فقط عندما تتنازل العمال (workers) لصالح حلقة الأحداث (event loop)
- كيف يبدو توقف واستئناف الموافقة البشرية في تدفق الأحداث، وأي الردود تفشل في التحقق من الصحة
- قائمة مراجعة للإنتاج مبنية على هذه النتائج، وسكريبت يعيد إنتاج كل قياس
ما هو الـ ADK 2.0 graph Workflow؟
وصل ADK Python 2.0 إلى التوفر العام في 19 مايو 2026،1 وتبعه ADK Go 2.0 في 30 يونيو 2026، و ADK TypeScript 2.0 في 21 أغسطس 2026.2 تسرد الوثائق ثلاث ميزات رئيسية: سير العمل القائم على الرسم البياني، وسير العمل الديناميكي، وسير العمل التعاوني المبني من وكلاء منسقين ووكلاء فرعيين متعددين.2 تتطلب حزمة Python إصدار Python 3.10 أو أحدث، وفقاً لبيانات PyPI ودليل البدء السريع لـ Python.34
يوضح منشور جوجل "لماذا بنينا ADK 2.0"، المنشور في 1 يوليو 2026، الدافع بشكل مباشر: "غالبًا ما تُكلف النماذج اللغوية الكبيرة بتنظيم التنفيذ — التعامل مع مهام مثل التوجيه، والجدولة، ومعالجة الأخطاء التي يتفوق فيها الكود التقليدي بالفعل. وبينما يمكنها إنجاز المهمة، إلا أنها بطيئة، ومكلفة، وتظهر تباينًا مقارنة بسير عمل أو كود حتمي."5 بعبارة أخرى، يقوم محرك سير العمل (Workflow engine) بنقل التوجيه ومعالجة الأخطاء من "المطالبة" (prompt) إلى الكود، وهو ما يختبره بقية هذا المنشور.
الإصدار الذي اختبرته، google-adk 2.10.0، مدرج على PyPI على أنه صدر في 25 سبتمبر 2026.3 كما تحذر وثائق ADK 2.0 من فخ في عملية النقل (migration trap) يؤثر على إعادة المحاولات والتوقفات البشرية. إذا قمت بنقل أداة وتركت كتلة except Exception: واسعة بداخلها، فإن "هذا الكود يخفي الفشل عن الإطار البرمجي، مما يؤدي إلى تعطيل آليات إعادة المحاولة التلقائية الجديدة في إصدار 2.0 بشكل دائم لتلك الخطوة"، كما أن التقاط BaseException "يؤدي دون قصد إلى حبس NodeInterruptedError، مما يكسر قدرة الإطار البرمجي على إيقاف سير العمل من أجل إدخال بشري (Human-in-the-Loop - HITL)."2
كيف اختبرت ذلك
كل فحص يقوم بتشغيل Workflow حقيقي من خلال InMemoryRunner الخاص بـ ADK باستخدام عقد وظائف Python بسيطة (بالإضافة إلى JoinNode واحدة)، لذا لا يعتمد أي شيء على زمن استجابة النموذج أو مفاتيح API. قمت بتثبيت google-adk 2.10.0 (مع google-genai 2.25.0) في أربع بيئات افتراضية، Python 3.10.20 و 3.11.15 و 3.12.3 و 3.13.13، وشغلت نفس السكريبت في كل منها. تستخدم المدد الزمنية time.monotonic()، ويتم تشغيل سير عمل واحد للتسخين أولاً حتى تظل تكاليف الاستيراد التي تحدث لمرة واحدة خارج التوقيتات، ويتم التقاط سجلات ADK عند مستوى WARNING وما فوق، لأن هذا هو المكان الذي تبين أن سلوكًا مهمًا واحدًا يكمن فيه. السكريبت الكامل موجود في قسم "إعادة الإنتاج" أدناه. وهذا هو هيكله:
log_lines = []
class Capture(logging.Handler):
    def emit(self, record):
        if record.levelno >= logging.WARNING:
            log_lines.append(record.getMessage())
logging.getLogger("google_adk").addHandler(Capture())

def user_msg(text):
    return types.Content(role="user", parts=[types.Part(text=text)])

async def run(wf, message=None, runner=None, session=None):
    """Run a workflow once. Returns (runner, session, events, exception_or_None)."""
    runner = runner or InMemoryRunner(agent=wf, app_name="demo")
    session = session or await runner.session_service.create_session(app_name="demo", user_id="u")
    events, error = [], None
    try:
        async for ev in runner.run_async(user_id="u", session_id=session.id,
                                         new_message=message or user_msg("go")):
            events.append(ev)
    except Exception as exc:
        error = exc
    return runner, session, events, error

def status(error):
    return type(error).__name__ if error else "completed"
يغطي هذا عقد الوظائف ووقت التشغيل المحيط بها. لم أختبر عقد LLM-agent، أو عقد الأدوات، أو سير العمل الديناميكي، أو خلفيات الجلسات المستمرة، أو المشغلات المنشورة، أو استئناف سير العمل بعد الانهيار، أو بعد إعادة التشغيل أو في منتصف إعادة المحاولة؛ الاستئناف الوحيد الذي اختبرته هو الرد داخل العملية على توقف الإدخال البشري الموضح أدناه.
ما هو سلوك إعادة المحاولة الافتراضي لعقدة ADK؟
العقدة التي لا تحتوي على retry_config لا يتم إعادة محاولتها من تلقاء نفسها، على الرغم من أنها قد تعمل مرة أخرى عندما يتم إعادة محاولة سير عمل يحتوي عليها، سواء كانت متداخلة أو في المستوى الأعلى (انظر القسم التالي). أما العقدة التي تحتوي على RetryConfig() مجردة، فتقوم بإجراء ما يصل إلى 5 محاولات، وتنتظر في المتوسط 1 و 2 و 4 و 8 ثوانٍ بينها، ثم تعيد إثارة الاستثناء الأخير. فترات الانتظار عشوائية، لأن قيمة jitter الافتراضية هي 1.0.
تأتي الإعدادات الافتراضية من مصدر الحزمة. توضح RetryConfig أن max_attempts افتراضياً هي 5 بما في ذلك الطلب الأصلي، و initial_delay هي 1.0 ثانية، و max_delay هي 60.0 ثانية، و backoff_factor هي 2.0 و jitter هي 1.0.6 يكون الانتظار الاسمي الأول هو initial_delay، وكل انتظار لاحق يتم ضربه في backoff_factor. عندما تكون قيمة jitter أكبر من صفر، تقوم دالة التأخير أولاً بتحديد سقف للانتظار الاسمي عند max_delay / (1 + jitter)، ثم تضيف إزاحة عشوائية يتم سحبها بانتظام بين سالب وموجب jitter × wait، بحيث لا يتجاوز الانتظار أبدًا max_delay.6 مع الإعدادات الافتراضية و 5 محاولات، يقع كل انتظار بين 0 وضعف قيمته الاسمية (1 أو 2 أو 4 أو 8 ثوانٍ)، لذا يمكن أن يصل مجموع فترات الانتظار الأربع إلى 30 ثانية.
يستخدم الفحص الخاص بي عقدة تثير دائمًا ConnectionError:
stamps = []
def always_fail(node_input: str):
    stamps.append(time.monotonic())
    raise ConnectionError("x")
node = FunctionNode(func=always_fail, name="f", retry_config=RetryConfig(jitter=0.0))
مع ضبط jitter=0.0، كانت الفجوات بين بدايات المحاولات الخمس هي 1.0، 2.01، 4.01 و 8.05 ثانية على Python 3.11.15، وفي حدود 0.05 ثانية من القيم الاسمية 1، 2، 4 و 8 ثوانٍ على كل مترجم (يقوم السكربت بتقريب الفجوات إلى 0.01 ثانية)، ووصل الفشل الخامس إلى المستدعي كـ ConnectionError. ومع الإعداد الافتراضي RetryConfig()، قمت بتشغيل 20 نسخة من نفس العقدة في وقت واحد. قامت جميع النسخ العشرين بإجراء 5 محاولات، وتراوح الوقت من بداية المحاولة الأولى إلى بداية المحاولة الخامسة من 6.6 ثانية إلى 25.4 ثانية (بمتوسط 14.3 ثانية) على Python 3.11.15، وليس 15 ثانية ثابتة. وتنوعت الفجوة قبل المحاولة الثانية من 0.18 ثانية إلى 2.00 ثانية، والفجوة قبل الخامسة من 1.32 ثانية إلى 15.85 ثانية. كل فجوة هي عبارة عن وقت الانتظار بالإضافة إلى قدر بسيط من العبء الإضافي (overhead) للمحاولة الفاشلة وعمليات التدوين الخاصة بـ ADK، والتي بلغت 0.05 ثانية أو أقل لكل فجوة في التشغيلات الخالية من الـ jitter. وأعطت دفعة ثانية مكونة من 20 نسخة على نفس المترجم نتائج من 6.3 ثانية إلى 26.2 ثانية (بمتوسط 13.3 ثانية)، لذا تعامل مع أي دفعة واحدة كعينة واحدة. وعبر المترجمات الأربعة، تراوحت الدفعات الأولى من 4.4 ثانية إلى 26.1 ثانية، وهو ما يقل عن الحد الأقصى البالغ 30 ثانية.
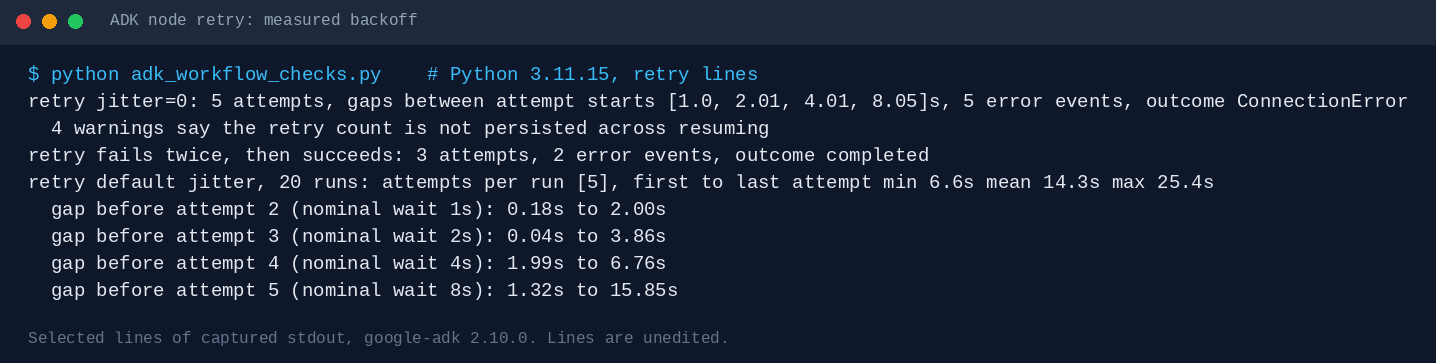
يترتب على ذلك ثلاث نتائج عملية. أولاً، ضع في اعتبارك الحد الأقصى وليس المتوسط: بموجب الإعدادات الافتراضية، يمكن للعقدة التي تفشل في كل مرة أن تقضي ما يصل إلى 30 ثانية في الانتظار بين المحاولات، بالإضافة إلى الوقت الذي تستغرقه المحاولات الخمس نفسها. ثانيًا، تضيف كل محاولة فاشلة لعقدة دالة (function node) حدث خطأ إلى التشغيل (5 أحداث لـ 5 محاولات في الفحص الخاص بي)، لأن مشغل العقدة يضع حدثًا في الطابور قبل أن يقرر ما إذا كان سيعيد المحاولة.6 وهذا ينطبق حتى عندما تنجح إعادة المحاولة في النهاية: فالعقدة التي فشلت مرتين ثم نجحت أجرت 3 محاولات، واكتملت، ومع ذلك تركت حدثي خطأ في التشغيل. ثالثًا، كل إعادة محاولة محلية تسجل WARNING يحتوي على "retry count is not persisted across resuming" (4 تحذيرات لعمليات إعادة المحاولة الأربع المذكورة أعلاه؛ الاستدعاء موجود في _node_runner.py).6 لم أختبر استئناف سير العمل (workflow) في منتصف إعادة المحاولة، لذا لا يمكنني تحديد ما تفعله العقدة المستأنفة بعداد محاولاتها. تعامل مع max_attempts كميزانية لتشغيل واحد للعقدة، وليس كميزانية دائمة: عندما يكون لسير العمل المحيط بالعقدة retry_config خاص به، فإن كل محاولة لسير العمل تشغل العقدة الفاشلة مرة أخرى بعداد جديد، وبالتالي تضرب الميزانيتان في بعضهما.6
كيف تقوم بتحديد إعادة المحاولات لاستثناءات معينة؟
قم بتمرير exceptions=[...] إلى RetryConfig مع فئات الاستثناءات أو أسماء الفئات. يقوم ADK بتحويل الفئات إلى أسمائها ويعيد محاولة الاستثناء إذا كانت فئته، أو أي فئة يرث منها بخلاف object، تحمل أحد الأسماء المدرجة.6 وهذا يشمل الفئات الفرعية، لذا فإن exceptions=[ConnectionError] يشمل أيضًا ConnectionResetError. كما يشمل الفئات غير المرتبطة التي تصادف أنها تشترك في الاسم: فمثلاً requests.exceptions.ConnectionError، التي ترث من OSError بدلاً من ConnectionError المدمجة، تمت إعادة محاولتها أيضًا.6 لقد تحققت من كل حالة:
| الخطأ الذي أطلقه الـ node | retry_config | عدد المحاولات | النتيجة |
|---|---|---|---|
ValueError | exceptions=[ConnectionError], max_attempts=4 | 1 | تم إطلاق ValueError |
ConnectionResetError | exceptions=[ConnectionError], max_attempts=4 | 4 | تم إطلاق ConnectionResetError |
ConnectionResetError | exceptions=["ConnectionError"] (سلسلة نصية), max_attempts=4 | 4 | تم إطلاق ConnectionResetError |
requests.exceptions.ConnectionError | exceptions=[ConnectionError], max_attempts=4 | 4 | تم إطلاق requests.exceptions.ConnectionError |
KeyError | exceptions غير محدد, max_attempts=4 | 4 | تم إطلاق KeyError |
ValueError | لا يوجد | 1 | تم إطلاق ValueError |
إعادة المحاولات اختيارية: في حالة عدم وجود retry_config على الـ node أو على أي workflow يحتوي عليه، بما في ذلك الـ Workflow الأساسي الذي تمرره إلى الـ runner، لن يتم إعادة محاولة التنفيذ عند الفشل. لم أجد أي قيمة افتراضية على مستوى الـ workflow للأبناء، لأن مصدر Workflow لا يحتوي على منطق لإعادة المحاولة و retry_config هو حقل خاص بكل node. ومع ذلك، فإن الـ Workflow هو في حد ذاته node، ووفقاً للـ docstring الخاص بـ retry_config، فإن وجود retry_config عليه يؤدي إلى إعادة محاولة تنفيذ الـ workflow ككل: الأبناء الذين أنتجوا بالفعل مخرجاً أو تغييراً في الحالة يتم إعادة تشغيلهم بدلاً من تنفيذهم مرة أخرى، أما الابن الذي لم ينتج أي منهما (عادةً هو الذي فشل) فيتم تنفيذه مرة أخرى، حتى بدون وجود retry_config خاص به.6 ترك exceptions غير محدد أدى إلى إعادة محاولة كل نوع من الاستثناءات التي أطلقتها، بما في ذلك مهلات الانتظار (timeouts) وأخطاء برمجية (KeyError)، لذا يفضل تحديد أنواع الاستثناءات العابرة التي تتوقعها فعلياً. أحد الآثار الجانبية لتحديدها: مهلة الانتظار تطلق NodeTimeoutError، والتي ترث مباشرة من Exception وليس من TimeoutError المدمج في Python، لذا فإن القائمة التي لا تذكر NodeTimeoutError ولا إحدى فئاتها الأساسية (Exception أو BaseException) ستوقف إعادة المحاولات لمهلات الانتظار، كما يوضح القسم التالي.6
لماذا لا يمكن لمهلة انتظار الـ node مقاطعة الكود الذي يتسبب في حظر التنفيذ (blocking code)؟
لأن ADK يفرض timeout باستخدام asyncio.wait_for، وبما أن الكود الذي يتسبب في حظر التنفيذ لا يعيد التحكم أبداً إلى حلقة الأحداث (event loop)، فلا يمكن لأي شيء إلغاؤه في منتصف الطريق. في _node_runner.py، يعمل الـ node الذي يحتوي على timeout داخل asyncio.wait_for(...)، ويتحول asyncio.TimeoutError الناتج إلى NodeTimeoutError.6 في _function_node.py، يتم استدعاء دالة def عادية (ليست generator) بشكل مباشر (result = self._func(**kwargs))، لذا فإن time.sleep(1.0) تحجز حلقة الأحداث لمدة ثانية كاملة، وكذلك يفعل أي استدعاء blocking داخل async def.6 يذكر الـ docstring الخاص بـ timeout في الحزمة أن الـ node الذي لا ينتهي في الوقت المحدد "يتم إلغاؤه والتعامل معه كفشل"، وفي اختباراتي حدث ذلك في الوقت المحدد فقط للـ nodes التي كانت في حالة انتظار await عند تجاوز الموعد النهائي.6
لقد أعطيت عقدة (node) جسماً يستغرق 1.0 ثانية و timeout قدره 0.3 ثانية، بسبعة أنماط، على أربعة مترجمات (time.sleep يمثل الاستدعاء المعطل "blocking call"، وتختلف الصفوف في ما تفعله العقدة حوله):
| جسم العقدة (يستغرق 1.0 ثانية) | Python 3.10 | Python 3.11 | Python 3.12 | Python 3.13 |
|---|---|---|---|---|
def + time.sleep(1.0) (sync_block) | اكتمل، 1.01 ثانية | اكتمل، 1.01 ثانية | NodeTimeoutError، 1.01 ثانية | NodeTimeoutError، 1.01 ثانية |
async def + await asyncio.sleep(1.0) (async_wait) | NodeTimeoutError، 0.31 ثانية | NodeTimeoutError، 0.31 ثانية | NodeTimeoutError، 0.31 ثانية | NodeTimeoutError، 0.31 ثانية |
async def + await asyncio.to_thread(time.sleep, 1.0) (async_thread) | NodeTimeoutError، 0.31 ثانية | NodeTimeoutError، 0.31 ثانية | NodeTimeoutError، 0.31 ثانية | NodeTimeoutError، 0.31 ثانية |
async def + blocking time.sleep(1.0) (async_block) | اكتمل، 1.01 ثانية | اكتمل، 1.01 ثانية | NodeTimeoutError، 1.01 ثانية | NodeTimeoutError، 1.01 ثانية |
async def + blocking time.sleep(1.0)، ثم await asyncio.sleep(0) (block_then_await) | NodeTimeoutError، 1.01 ثانية | NodeTimeoutError، 1.01 ثانية | NodeTimeoutError، 1.01 ثانية | NodeTimeoutError، 1.01 ثانية |
async def + blocking time.sleep(1.0)، ثم await لـ coroutine تعود بدون تعليق (block_then_noop) | اكتمل، 1.04 ثانية | اكتمل، 1.01 ثانية | NodeTimeoutError، 1.01 ثانية | NodeTimeoutError، 1.01 ثانية |
def + time.sleep(1.0)، لا تعيد شيئاً (block_no_output) | اكتمل، 1.01 ثانية | اكتمل، 1.01 ثانية | اكتمل، 1.01 ثانية | اكتمل، 1.01 ثانية |
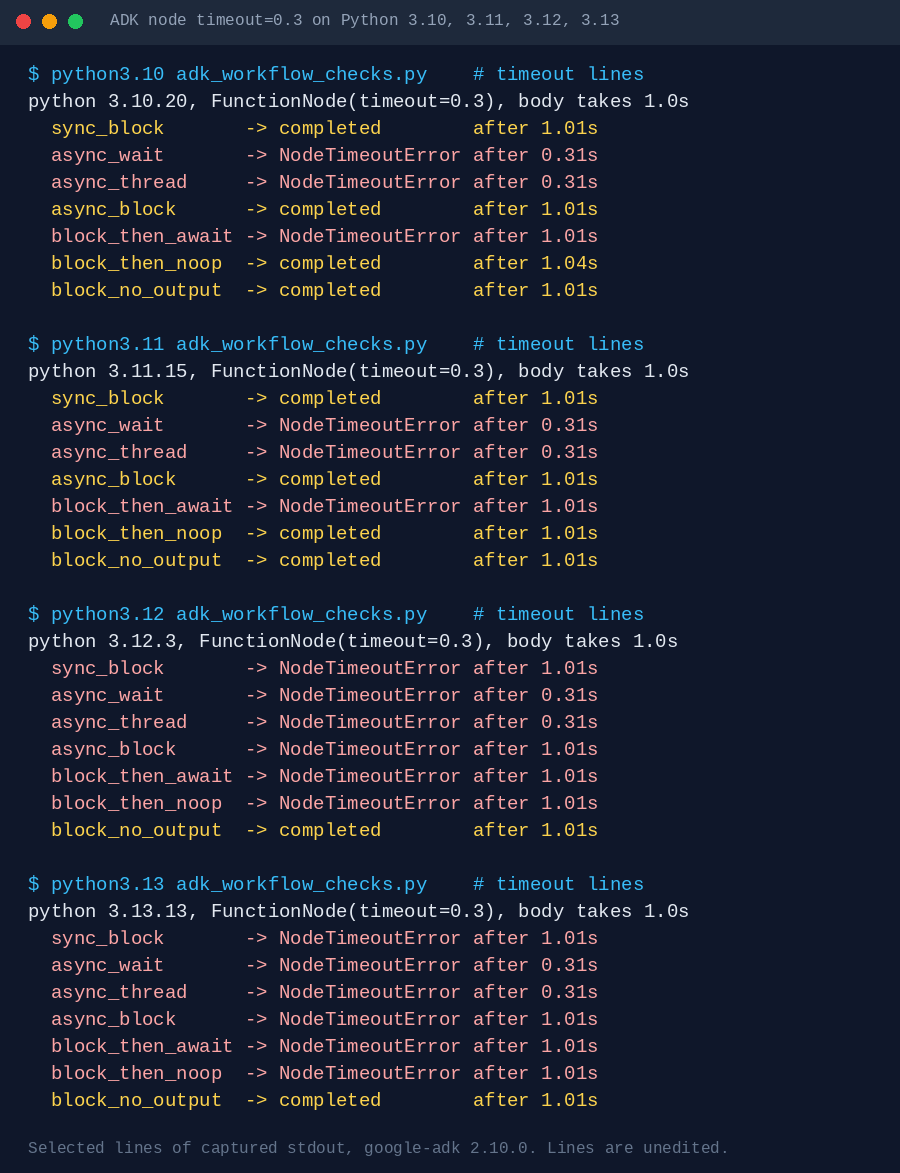
لم يتم مقاطعة الأجسام المعطلة: جميع المتغيرات الخمسة المعطلة عملت لمدة ثانية كاملة على كل مترجم (من 1.01 إلى 1.04 ثانية عبر هذه التشغيلات)، وفي أي من هذه التشغيلات لم يتم تفعيل الـ timeout عند 0.3 ثانية لجسم معطل. ما حدث بمجرد عودة الاستدعاء اعتمد على ما فعلته العقدة تالياً وعلى المترجم. الجسم الذي أعاد قيمة مباشرة بعد التعطيل (sync_block, async_block) اكتمل على Python 3.10 و 3.11 وفشل بـ NodeTimeoutError على 3.12 و 3.13، بعد حوالي 1.0 ثانية. أما الجسم الذي سلم التحكم بعد ذلك إلى حلقة الأحداث (event loop) (block_then_await، الذي ينتظر asyncio.sleep(0)) فقد فشل في جميع المترجمات الأربعة. الانتظار (Awaiting) ليس هو نفسه التنازل (yielding): فـ block_then_noop، الذي ينتظر coroutine تعود بدون تعليق، كانت له نفس نتيجة async_block على كل مترجم. أما الجسم الذي لم يعد شيئاً ولم يكتب أي حالة للجلسة (block_no_output) فقد اكتمل على جميع المترجمات الأربعة.
ينتج هذا النمط عما يحدث عندما يستعيد حلقة الأحداث (event loop) السيطرة، وهو ما يحدث فقط عندما يتوقف كود العقدة (node) مؤقتاً أو ينتهي. عندما تطلق العقدة حدث مخرجات، يقوم ADK بتسليم الحدث إلى المشغل (runner) ثم ينتظر المشغل لمعالجته (await processed.wait() في invocation_context.py)؛ هذا الانتظار هو أول نقطة بعد الاستدعاء الحاجب (blocking call) حيث يمكن للحلقة، ومعها المؤقت المتأخر، أن تعمل. الجسم الذي يتوقف مؤقتاً من تلقاء نفسه بعد الحجب يصل إلى هذه النقطة بشكل أسرع. أما الجسم الذي لا يعيد شيئاً ولا يكتب أي حالة فلا يطلق أي حدث على الإطلاق، وبالتالي لا يتوقف مؤقتاً أبداً؛ بينما الإعادة بقيمة None التي تكتب في ctx.state تظل تطلق حدث حالة.6 ما يفعله المؤقت حينها يختلف حسب المفسر (interpreter)، والنتائج تتوافق مع asyncio.wait_for في كل إصدار.7 في إصداري 3.12 و 3.13، يستخدم wait_for دالة asyncio.timeout()، والتي تلغي المهمة بمجرد أن تشغل الحلقة المؤقت المتأخر، لذا فإن كل جسم حاجب توقف مؤقتاً بعد ذلك قد فشل، بينما الجسم الذي لم يتوقف مؤقتاً أبداً قد اكتمل. في إصداري 3.10 و 3.11، يقوم wait_for بتشغيل العقدة كمهمة منفصلة، وعندما يستيقظ، يعيد النتيجة إذا كانت تلك المهمة قد انتهت بالفعل (if fut.done(): return fut.result())، لذا تعتمد النتيجة على الترتيب الذي تشغل به الحلقة استدعاءات الرد (callbacks) المجدولة خلف الاستدعاء الحاجب. لم أتتبع هذا الترتيب خطوة بخطوة، لذا اعتبر هذا التفسير هو المرجح والجدول هو النتيجة المقاسة.
الحل هو إبقاء حلقة الأحداث حرة: استخدم عميلاً غير متزامن (async client) لاستدعاءات الشبكة، أو غلف الاستدعاء الحاجب بـ asyncio.to_thread، والذي انتهى وقته عند 0.31 ثانية في كل مفسر. لكن to_thread يتخلى فقط عن الانتظار؛ ولا يوقف الخيط (thread). مع timeout=0.2 و RetryConfig(max_attempts=3, initial_delay=0.05, jitter=0.0) حول استدعاء حاجب لمدة ثانية واحدة، كانت جميع المحاولات الثلاث قد بدأت ولم تنتهِ أي منها عندما أطلق run_async خطأ NodeTimeoutError، وانتهت جميع المحاولات الثلاث بعد 1.5 ثانية (متطابق في جميع إصدارات Python الأربعة). لذا فإن كل إعادة محاولة لعقدة to_thread يمكن أن تترك نسخة أخرى من الاستدعاء الحاجب تعمل. إذا كان لهذا الاستدعاء آثار جانبية، فاجعله idempotent (متماثل القيمة).
تتكامل المهلات (timeouts) وإعادة المحاولات، ولكن فقط إذا كانت سياسة إعادة المحاولة تغطي المهلة. مع exceptions=[ConnectionError] أو exceptions=[TimeoutError]، قامت العقدة التي انتهت مهلتها بمحاولة واحدة ولم تتم إعادة محاولتها، بينما مع exceptions=['NodeTimeoutError'] قامت بـ 3 محاولات، في جميع المفسرات الأربعة. مع timeout=0.3 و RetryConfig(max_attempts=3, initial_delay=0.1, jitter=0.0) وبدون قائمة exceptions، قامت عقدة غير متزامنة لم تنتهِ أبداً أيضاً بـ 3 محاولات، بدأت عند 0.0 ثانية، 0.4 ثانية و 0.9 ثانية (الثالثة عند 0.91 ثانية في Python 3.10 و 3.11)، ثم أطلقت NodeTimeoutError. لذا بالنسبة لعقدة تقوم بالتنازل (yield)، فإن أسوأ حالة زمن استجابة هي تقريباً max_attempts × timeout بالإضافة إلى فترات انتظار التراجع (backoff waits): هنا 3 × 0.3 + 0.1 + 0.2 = 1.2 ثانية مع jitter=0.0، ومع الـ jitter الافتراضي يمكن أن يصل كل انتظار إلى ضعف قيمته الاسمية. الجسم الحاجب لا يتم قطعه، لذا يمكن لكل محاولة أن تعمل طوال وقت جسمها الكامل. مع نفس الإعدادات وجسم حاجب لمدة 1.0 ثانية، قام Python 3.12 و 3.13 بثلاث محاولات واستغرق ما بين 3.31 إلى 3.32 ثانية في المجمل، بما يتماشى مع 3 × 1.0 ثانية بالإضافة إلى انتظارات 0.1 ثانية و 0.2 ثانية، بينما اكتمل Python 3.10 و 3.11 في المحاولة الأولى بعد 1.01 ثانية.
ماذا يحدث عندما لا يتطابق المسار مع أي شيء؟
لا يتم إطلاق أي استثناء. عندما لا يتطابق أي طرف موجه (routed edge) ولا يوجد DEFAULT_ROUTE، لا يعمل أي من الخلفاء الموجهين، وينتهي الفرع هناك ما لم يكن للموجه أيضاً طرف غير موجه، والذي يتم اتباعه في هذه الحالة. تعيد عقدة التوجيه Event(output=..., route="...")، وتختار خريطة الأطراف الخلف (successor). في اختباري، أطلقت العقدة المسار "nope"، وقمت بتشغيلها مقابل ثلاث قوائم أطراف:
def classify(node_input: str):
    return Event(output=node_input, route="nope")
def yes(node_input: str): return "YES"
def fallback(node_input: str): return "FALLBACK"
def always(node_input: str): return "ALWAYS"
cases = {
    "no default": [("START", classify, {"yes": yes})],
    "DEFAULT_ROUTE": [("START", classify, {"yes": yes, DEFAULT_ROUTE: fallback})],
    "no default, plus an unrouted edge": [("START", classify, {"yes": yes}), (classify, always)],
}
مع وجود حواف موجهة فقط وبدون مسار افتراضي، اكتمل سير العمل بشكل طبيعي بمخرج واحد 'go'، ولم يتم تشغيل أي شيء في المراحل اللاحقة، وسجل ADK تحذيراً واحداً: Node 'classify' has conditional/DEFAULT edges but none were matched by the emitted route(s): nope. The branch will end. ومع وجود DEFAULT_ROUTE: fallback في الخريطة، تم تشغيل عقدة fallback، وكانت المخرجات ['go', 'FALLBACK']، ولم يكن هناك أي تحذير. ومع وجود حافة إضافية غير موجهة من الموجه (router) إلى always، لم يتسبب المسار غير المتطابق في أي خطأ ولم يتم تسجيل أي شيء: تم تشغيل always وكانت المخرجات ['go', 'ALWAYS']. في _graph.py، يتم اتباع الحواف التي لا تحتوي على مسار دائماً، ويتم تسجيل التحذير فقط عندما تنتهي عقدة تحتوي على حواف موجهة دون جدولة أي شيء.6
تصف صفحة المسارات DEFAULT_ROUTE في قسم TypeScript الخاص بها على أنه إعداد "يتطابق عندما لا يتطابق أي مسار آخر على نفس العقدة المصدر"، ويوثق قسم Go الخاص بها ما يعادل ذلك في workflow.Default. لم أجد أي مثال بلغة Python لذلك في تلك الصفحة ولا أي بيان حول حالة عدم التطابق بدون مسار افتراضي.8 ما يحدث هناك يأتي من تشغيله ومن _graph.py.6 امنح كل موجه DEFAULT_ROUTE. إذا كانت قيمة المسار تأتي من شيء لا تتحكم فيه، مثل تسمية المصنف (classifier's label)، فقم بتوجيه المسار الافتراضي إلى عقدة تسجل المشكلة وتصعدها. كما يساعد التنبيه بناءً على نص التحذير أيضاً، ولكنه يلتقط فقط الموجهات التي تكون جميع حوافها الصادرة موجهة.
كيف يتصرف الـ fan-out والـ JoinNode؟
يعمل الـ Fan-out بشكل صحيح، ويتم تعريف JoinNode على أنها عقدة "تنتظر جميع السلائف المحددة" قبل إخراج النتائج.6 في كل عملية تشغيل، كان مخرج الربط عبارة عن قاموس (dict) مفتاحه اسم العقدة، {'w1': 'done', 'w2': 'done'} (تغير ترتيب المفاتيح بين عمليات التشغيل). ما تغير هو الوقت المنقضي، والذي اعتمد على ما إذا كان العمال (workers) قد تركوا المجال لحلقة الأحداث (event loop). كل عامل من العاملين ينتظر 0.3 ثانية:
| جسم العامل (عاملان، 0.3 ثانية لكل منهما) | الوقت المنقضي عبر المفسرات الأربعة |
|---|---|
def + time.sleep(0.3) | 0.61 إلى 0.62 ثانية |
async def + await asyncio.sleep(0.3) | 0.31 ثانية |
async def + await asyncio.to_thread(time.sleep, 0.3) | 0.31 إلى 0.33 ثانية |
async def + blocking time.sleep(0.3) | 0.61 ثانية |
القاعدة هي نفسها بالنسبة لمهل الانتظار (timeouts): العمال الذين يحجبون حلقة الأحداث يتناوبون، والعمال الذين يتنازلون عن التنفيذ أثناء الانتظار يتداخلون. مجرد تحديد الدالة كـ async def ليس كافياً. الصف الرابع يمثل عاملاً async def يقوم بالحجب، وبالتالي لا يحصل على أي زيادة في السرعة.
كيف يعمل التدخل البشري (human-in-the-loop) في سير العمل (Workflow)؟
عندما تقوم عقدة (node) بإرجاع أو إنتاج RequestInput، يتوقف التشغيل مؤقتاً، ويقوم العميل باستئنافه من خلال استجابة دالة (function response) تحمل معرف المقاطعة (interrupt ID). في تجاربي، سواء كانت العقدة ترجع RequestInput أو تنتجه، فقد نتج عن ذلك استدعاء دالة adk_request_input. تذكر الوثائق ثلاثة خيارات لـ RequestInput وهي (message و payload و response_schema)، ويذكر قسم Python أنه بمجرد استلام النظام مدخلات من المستخدم، "يتم تمرير هذه المدخلات إلى العقدة التالية".9 ويضيف قسم TypeScript أنه مع القيمة الافتراضية للورقة rerunOnResume: false، "يتم توجيه الرد إلى العقدة التالية كمدخلات، متجاوزاً العقدة التي تم مقاطعتها".9 وفي حزمة Python، تقوم FunctionNode أيضاً بتعيين القيمة الافتراضية لـ rerun_on_resume على false.6
سلسلة الاختبار الرئيسية الخاصة بي تربط بين draft و approve و execute، حيث ترجع approve قيمة RequestInput(message=..., payload=..., response_schema=str). توقف التشغيل الأول عند approve. حمل حدث ما استدعاء دالة باسم adk_request_input مع interruptId و payload و message و response_schema بقيمة {'type': 'string'}، وكانت العدادات تشير إلى draft 1، approve 1، execute 0. استأنفت التشغيل باستخدام FunctionResponse كانت استجابته {"result": "yes approved"}:
def reply(call, value):
    return types.Content(role="user", parts=[types.Part(function_response=types.FunctionResponse(
        id=call.id, name="adk_request_input", response=value))])
استلمت execute السلسلة النصية من مفتاح result وأرجعت EXECUTED after human said: 'yes approved'. ثم أصبحت العدادات draft 1، approve 1، execute 1، مما يعني أن أياً من العقد السابقة لم يتم تشغيلها مرة أخرى.
يتم فرض مخطط الاستجابة (response schema). الرد بالرقم 42 ({"result": 42}) على طلب response_schema=str جعل run_async تثير خطأ WorkflowDataError، وتم تشغيل execute صفر من المرات. تم قبول نفس الرد عندما لم يكن لـ RequestInput أي response_schema، وحينها استلمت execute العدد الصحيح 42. كما يقوم ADK بتمرير النص الموجود داخل رد {"result": "..."} عبر json.loads الخاصة بـ Python قبل التحقق من صحته (_rehydration_utils.py)، لذا فإن أي نص يتم تحليله إلى شيء آخر غير السلسلة النصية يفشل في مخطط str.6 الردود المكتوبة كنص 42 وكـ true أثارت كلاهما WorkflowDataError، مع تشغيل execute صفر من المرات، بينما 042، التي يرفضها json.loads بسبب الصفر البادئ، وصلت إلى execute دون تغيير كسلسلة نصية '042'. كما أن محلل Python أكثر تساهلاً من JSON: فهو يحول NaN و Infinity و -Infinity إلى أرقام عشرية (floats)، لذا فإن هذه الردود تفشل أيضاً في مخطط str. تذكر صفحة مدخلات المستخدم أيضاً أن ADK Go لا يقوم تلقائياً بتحليل أو التحقق من بنية الرد، لذا لا تفترض أن سلوك Python ينطبق على جميع SDKs.9 في Python، قم بتعريف response_schema لكل توقف، وكن مستعداً لمعالجة الخطأ في المكان الذي تقدم فيه الردود، وتوقع أن الشخص الذي يكتب true أو 42 في حقل نصي سيؤدي إلى تفعيل هذا الخطأ.
تحذير واحد من وثائق الاستئناف (resume)، والتي تغطي استئناف سير عمل وكيل متوقف عن طريق معرف الاستدعاء (invocation ID): ميزة الاستئناف "تضمن تشغيل الأدوات (Tools) في الوكيل مرة واحدة على الأقل، وقد يتم تشغيلها أكثر من مرة عند استئناف سير العمل."10 يدرج بانر الإصدار في تلك الصفحة Python v1.16.0 و Kotlin v0.1.0، وهي تغطي ResumabilityConfig مع الوكلاء المتسلسلين، والحلقات، والمتوازيين، والمخصصين، ولا تذكر سير عمل الرسوم البيانية (graph workflows) أو RequestInput، لذا لا يمكنني تحديد كيفية تطبيق ذلك على عقد الرسوم البيانية. في تجربتي، لم يتم إعادة تشغيل أي عقدة سابقة بعد رد بشري. كإجراء احترازي، اجعل أي عقدة ذات تأثيرات جانبية يمكن إعادة تشغيلها بعد المقاطعة "idempotent" (غير متغيرة النتيجة عند التكرار).
قائمة مراجعة الإنتاج لـ ADK Workflows
| المشكلة | ما وجدته | ما يجب فعله |
|---|---|---|
| ميزانية إعادة المحاولة (Retry budget) | استخدام RetryConfig() فارغ يعني 5 محاولات؛ مع الـ jitter الافتراضي، تتراوح أوقات المحاولة الأولى إلى الأخيرة من 4.4 إلى 26.1 ثانية في الدفعات الأولى على أربعة مفسرات، ويمكن أن يصل مجموع فترات الانتظار الأربعة إلى 30 ثانية | قم بتحديد max_attempts و initial_delay و jitter بشكل مقصود؛ وخصص ميزانية للحد الأقصى |
| نطاق إعادة المحاولة (Retry scope) | عدم وجود retry_config يعني أن العقدة لا يتم إعادة محاولتها بمفردها؛ عدم تعيين exceptions يؤدي لإعادة محاولة كل استثناء أقوم بإثاره، بما في ذلك المهلات (timeouts)؛ الأسماء المدرجة تطابق فئة الاستثناء أو أي فئة أساسية باستثناء object، حسب الاسم | أدرج أنواع الاستثناءات العابرة، وقم بتضمين NodeTimeoutError إذا كان يجب إعادة محاولة المهلات |
| المهلات (Timeouts) | لا يمكن مقاطعة الكود الذي يتسبب في حظر (blocking code)؛ بعد ذلك تكتمل العقدة أو تفشل متأخرة، اعتمادًا على ما تفعله لاحقًا وعلى إصدار Python | استخدم كود async غير حاصر، أو asyncio.to_thread للمكالمات الحاصرة |
المهلة مع to_thread | تظل الخيوط (Threads) تعمل بعد انتهاء المهلة: 3 من أصل 3 لم تنتهِ عند إثارة run_async | اجعل المكالمة الحاصرة idempotent قبل دمجها مع عمليات إعادة المحاولة |
| المهلة بالإضافة إلى إعادة المحاولة | العقدة التي تقوم بـ Yielding: محاولات عند حوالي 0.0 و 0.4 و 0.9 ثانية مع timeout=0.3؛ الجسم الحاصر: 3 محاولات استغرقت من 3.31 إلى 3.32 ثانية على 3.12 و 3.13 | خصص ميزانية max_attempts × timeout للعقد التي تقوم بـ yielding و max_attempts × body time للعقد الحاصرة، بالإضافة إلى فترات انتظار التراجع (backoff waits) في كلتا الحالتين |
| التوجيه (Routing) | المسار غير المتطابق لا يثير خطأ؛ مع وجود حواف موجهة فقط ينتهي الفرع بتحذير واحد، ومع وجود حافة غير موجهة أيضًا لا يتم تسجيل أي شيء | أضف DEFAULT_ROUTE إلى كل موجه (router)؛ قم بالتنبيه عند ظهور التحذير، ولكن لا تعتمد عليه وحده |
| التوزيع (Fan-out) | العمال الحاصرون (Blocking workers) عملوا في 0.61 إلى 0.62 ثانية، والعمال الذين يقومون بـ yielding في 0.31 إلى 0.33 ثانية | اجعل العمال المتوازيين يقومون بـ yield |
| التوقف البشري (Human pause) | مع القيمة الافتراضية rerun_on_resume=False، يذهب الرد إلى الخلف؛ الرد الذي يكسر response_schema يثير WorkflowDataError، وبالنسبة لمخطط str يتضمن نصًا يحوله json.loads إلى قيمة غير نصية | قم بتعيين response_schema وتعامل مع الخطأ |
| التعافي من الانهيار (Crash recovery) | كل إعادة محاولة تسجل أن عدد إعادة المحاولات لا يتم حفظه عبر الاستئناف (لم يتم اختبار الاستئناف في منتصف إعادة المحاولة أو بعد الانهيار) | لا تتعامل مع max_attempts كميزانية دائمة |
لقراءات ذات صلة على نيرد ليفل تك، يغطي Managed Agent Runtimes: AWS, Google, Alibaba in 2026 منصة Gemini Enterprise Agent من Google جنبًا إلى جنب مع AWS و Alibaba، ويغطي AI Agents in Go: Microsoft Joins Google's Bet in 2026 نظام ADK من Google للغة Go و Agent Framework من Microsoft للغة Go، وإذا كانت إحدى عقدك تنتظر مكالمة أداة MCP بطيئة، فإن MCP Tasks Extension: A Working Python Server (2026) يوضح كيفية إعادة مقبض المهمة (task handle) بدلاً من الحظر.
إعادة التجربة
قم بتثبيت google-adk 2.10.0 في بيئة افتراضية جديدة (pip install google-adk==2.10.0 google-genai==2.25.0؛ سيؤدي هذا أيضًا إلى تثبيت requests، وهي تبعية لـ google-adk يستوردها السكربت)، واحفظ السكربت أدناه باسم adk_workflow_checks.py وقم بتشغيل python adk_workflow_checks.py. يستغرق التشغيل الكامل حوالي دقيقة واحدة على جهازي. مرر واحدًا أو أكثر من retry، أو scope، أو timeout، أو route، أو fanout أو hitl لتشغيل تلك الفحوصات فقط. أرقام الـ jitter الافتراضية عشوائية وكل مدة تعتمد على جهازك، لذا توقع نفس النمط بدلاً من نفس الكسور العشرية.
"""Checks for google-adk 2.10.0 Workflow behavior. Run: python adk_workflow_checks.py [retry|scope|timeout|route|fanout|hitl]"""
import asyncio, logging, statistics, sys, time
import requests  # installed with google-adk, which depends on it
from google.adk import Event
from google.adk.events import RequestInput
from google.adk.runners import InMemoryRunner
from google.adk.workflow import DEFAULT_ROUTE, FunctionNode, JoinNode, RetryConfig, Workflow
from google.genai import types

log_lines = []
class Capture(logging.Handler):
    def emit(self, record):
        if record.levelno >= logging.WARNING:
            log_lines.append(record.getMessage())
logging.getLogger("google_adk").addHandler(Capture())

def user_msg(text):
    return types.Content(role="user", parts=[types.Part(text=text)])

async def run(wf, message=None, runner=None, session=None):
    """Run a workflow once. Returns (runner, session, events, exception_or_None)."""
    runner = runner or InMemoryRunner(agent=wf, app_name="demo")
    session = session or await runner.session_service.create_session(app_name="demo", user_id="u")
    events, error = [], None
    try:
        async for ev in runner.run_async(user_id="u", session_id=session.id,
                                         new_message=message or user_msg("go")):
            events.append(ev)
    except Exception as exc:
        error = exc
    return runner, session, events, error

def status(error):
    return type(error).__name__ if error else "completed"

async def retry():
    log_lines.clear()
    stamps = []
    def always_fail(node_input: str):
        stamps.append(time.monotonic())
        raise ConnectionError("x")
    node = FunctionNode(func=always_fail, name="f", retry_config=RetryConfig(jitter=0.0))
    _, _, events, error = await run(Workflow(name="retry", edges=[("START", node)]))
    gaps = [round(b - a, 2) for a, b in zip(stamps, stamps[1:])]
    errors = sum(1 for e in events if e.error_message)
    print(f"retry jitter=0: {len(stamps)} attempts, gaps between attempt starts {gaps}s, "
          f"{errors} error events, outcome {status(error)}")
    persisted = [m for m in log_lines if "not persisted across resuming" in m]
    print(f"  {len(persisted)} warnings say the retry count is not persisted across resuming")

    tries = []
    def flaky(node_input: str):
        tries.append(1)
        if len(tries) < 3:
            raise ConnectionError("x")
        return "ok"
    node = FunctionNode(func=flaky, name="f", retry_config=RetryConfig(jitter=0.0, initial_delay=0.05))
    _, _, events, error = await run(Workflow(name="flaky", edges=[("START", node)]))
    errors = sum(1 for e in events if e.error_message)
    print(f"retry fails twice, then succeeds: {len(tries)} attempts, {errors} error events, outcome {status(error)}")

    async def one_run():          # default RetryConfig(): jitter left at its default
        marks = []
        def fail(node_input: str):
            marks.append(time.monotonic())
            raise ConnectionError("x")
        wf = Workflow(name="j", edges=[("START", FunctionNode(func=fail, name="f", retry_config=RetryConfig()))])
        await run(wf)
        return [b - a for a, b in zip(marks, marks[1:])]
    runs = await asyncio.gather(*[one_run() for _ in range(20)])
    totals = [sum(r) for r in runs]
    print(f"retry default jitter, 20 runs: attempts per run {sorted({len(r) + 1 for r in runs})}, "
          f"first to last attempt min {min(totals):.1f}s mean {statistics.mean(totals):.1f}s max {max(totals):.1f}s")
    for i in range(4):
        col = [r[i] for r in runs]
        print(f"  gap before attempt {i + 2} (nominal wait {2 ** i}s): {min(col):.2f}s to {max(col):.2f}s")

async def scope():
    async def calls(label, raises, retry_config):
        n = {"calls": 0}
        def flaky(node_input: str):
            n["calls"] += 1
            raise raises("x")
        node = FunctionNode(func=flaky, name="f", retry_config=retry_config)
        _, _, _, error = await run(Workflow(name="scope", edges=[("START", node)]))
        print(f"scope {label}: {n['calls']} call(s), outcome {status(error)}")
    only_conn = RetryConfig(max_attempts=4, initial_delay=0.05, jitter=0.0, exceptions=[ConnectionError])
    by_name = RetryConfig(max_attempts=4, initial_delay=0.05, jitter=0.0, exceptions=["ConnectionError"])
    anything = RetryConfig(max_attempts=4, initial_delay=0.05, jitter=0.0)
    await calls("exceptions=[ConnectionError], ValueError raised", ValueError, only_conn)
    await calls("exceptions=[ConnectionError], ConnectionResetError raised", ConnectionResetError, only_conn)
    await calls("exceptions=['ConnectionError'] (a string), ConnectionResetError raised", ConnectionResetError, by_name)
    await calls("exceptions=[ConnectionError], requests.exceptions.ConnectionError raised",
                requests.exceptions.ConnectionError, only_conn)
    await calls("exceptions unset, KeyError raised", KeyError, anything)
    await calls("no retry_config, ValueError raised", ValueError, None)

async def timeout():
    def sync_block(node_input: str):
        time.sleep(1.0); return "late"
    async def async_wait(node_input: str):
        await asyncio.sleep(1.0); return "late"
    async def async_thread(node_input: str):
        await asyncio.to_thread(time.sleep, 1.0); return "late"
    async def async_block(node_input: str):
        time.sleep(1.0); return "late"
    async def block_then_await(node_input: str):
        time.sleep(1.0); await asyncio.sleep(0); return "late"
    async def returns_at_once():
        return None
    async def block_then_noop(node_input: str):
        time.sleep(1.0); await returns_at_once(); return "late"
    def block_no_output(node_input: str):
        time.sleep(1.0)
    print(f"python {sys.version.split()[0]}, FunctionNode(timeout=0.3), body takes 1.0s")
    for fn in (sync_block, async_wait, async_thread, async_block, block_then_await, block_then_noop,
               block_no_output):
        node = FunctionNode(func=fn, name=fn.__name__, timeout=0.3)
        start = time.monotonic()
        _, _, _, error = await run(Workflow(name="t", edges=[("START", node)]))
        print(f"  {fn.__name__:16} -> {status(error):16} after {time.monotonic() - start:.2f}s")
    # timeout + retry: attempt start offsets
    starts = []
    async def slow(node_input: str):
        starts.append(time.monotonic()); await asyncio.sleep(2)
    node = FunctionNode(func=slow, name="slow", timeout=0.3,
                        retry_config=RetryConfig(max_attempts=3, initial_delay=0.1, jitter=0.0))
    _, _, _, error = await run(Workflow(name="tr", edges=[("START", node)]))
    print(f"  timeout+retry(3): attempts at {[round(s - starts[0], 2) for s in starts]}, outcome {status(error)}")
    # does a timeout retry when exceptions is scoped?
    for label, excs in (("exceptions=[ConnectionError]", [ConnectionError]),
                        ("exceptions=[TimeoutError]", [TimeoutError]),
                        ("exceptions=['NodeTimeoutError']", ["NodeTimeoutError"])):
        seen = []
        async def slow_scoped(node_input: str):
            seen.append(1); await asyncio.sleep(2)
        node = FunctionNode(func=slow_scoped, name="slow_scoped", timeout=0.3,
                            retry_config=RetryConfig(max_attempts=3, initial_delay=0.05, jitter=0.0, exceptions=excs))
        _, _, _, error = await run(Workflow(name="ts", edges=[("START", node)]))
        print(f"  timeout + retry {label}: {len(seen)} attempt(s), outcome {status(error)}")
    # a blocking body with timeout and retry
    begins = []
    async def blocking_retry(node_input: str):
        begins.append(time.monotonic()); time.sleep(1.0); return "late"
    node = FunctionNode(func=blocking_retry, name="blocking_retry", timeout=0.3,
                        retry_config=RetryConfig(max_attempts=3, initial_delay=0.1, jitter=0.0))
    start = time.monotonic()
    _, _, _, error = await run(Workflow(name="br", edges=[("START", node)]))
    print(f"  blocking body + timeout + retry(3): attempts at {[round(b - begins[0], 2) for b in begins]}, "
          f"{time.monotonic() - start:.2f}s in total, outcome {status(error)}")
    # threads survive a timeout
    live = {"started": 0, "finished": 0}
    async def threaded(node_input: str):
        def blocking():
            live["started"] += 1; time.sleep(1.0); live["finished"] += 1
        await asyncio.to_thread(blocking)
    node = FunctionNode(func=threaded, name="threaded", timeout=0.2,
                        retry_config=RetryConfig(max_attempts=3, initial_delay=0.05, jitter=0.0))
    _, _, _, error = await run(Workflow(name="th", edges=[("START", node)]))
    at_return = dict(live)
    await asyncio.sleep(1.5)
    print(f"  to_thread+timeout+retry(3): outcome {status(error)}; at return {at_return}; 1.5s later {live}")

async def route():
    def classify(node_input: str):
        return Event(output=node_input, route="nope")
    def yes(node_input: str): return "YES"
    def fallback(node_input: str): return "FALLBACK"
    def always(node_input: str): return "ALWAYS"
    cases = {
        "no default": [("START", classify, {"yes": yes})],
        "DEFAULT_ROUTE": [("START", classify, {"yes": yes, DEFAULT_ROUTE: fallback})],
        "no default, plus an unrouted edge": [("START", classify, {"yes": yes}), (classify, always)],
    }
    for label, edges in cases.items():
        log_lines.clear()
        _, _, events, error = await run(Workflow(name="r", edges=edges))
        print(f"route {label}: {status(error)}, outputs {[e.output for e in events]}, warnings {log_lines}")

async def fanout():
    async def split(node_input: str): return node_input
    def sync_w(node_input: str):
        time.sleep(0.3); return "done"
    async def async_w(node_input: str):
        await asyncio.sleep(0.3); return "done"
    async def thread_w(node_input: str):
        await asyncio.to_thread(time.sleep, 0.3); return "done"
    async def block_w(node_input: str):
        time.sleep(0.3); return "done"
    for fn in (sync_w, async_w, thread_w, block_w):
        w1, w2 = FunctionNode(func=fn, name="w1"), FunctionNode(func=fn, name="w2")
        wf = Workflow(name="f", edges=[("START", split, (w1, w2), JoinNode(name="join"))])
        start = time.monotonic()
        _, _, events, error = await run(wf)
        joined = [e.output for e in events if isinstance(e.output, dict)]
        print(f"fanout {fn.__name__:8} -> {time.monotonic() - start:.2f}s, join output {joined}, {status(error)}")

async def hitl():
    counts = {"draft": 0, "approve": 0, "execute": 0}
    def draft(node_input: str):
        counts["draft"] += 1; return f"REFUND $500 for {node_input}"
    def make_approve(schema):
        def approve(node_input: str):
            counts["approve"] += 1
            return RequestInput(message=f"Approve? {node_input}", payload=node_input, response_schema=schema)
        return approve
    def execute(node_input):
        counts["execute"] += 1; return f"EXECUTED after human said: {node_input!r}"
    def reply(call, value):
        return types.Content(role="user", parts=[types.Part(function_response=types.FunctionResponse(
            id=call.id, name="adk_request_input", response=value))])
    async def pause(schema, order):
        for key in counts: counts[key] = 0
        wf = Workflow(name="h", edges=[("START", draft, make_approve(schema), execute)])
        runner, session, events, _ = await run(wf, user_msg(order))
        return wf, runner, session, [fc for e in events for fc in e.get_function_calls()][0]

    wf, runner, session, call = await pause(str, "order-17")
    print(f"hitl pause: function call {call.name!r}, args {call.args}, counts {counts}")
    _, _, events, error = await run(wf, reply(call, {"result": "yes approved"}), runner, session)
    print(f"hitl resume: {status(error)}, outputs {[e.output for e in events]}, counts {counts}")

    def approve_yield(node_input: str):
        yield RequestInput(message=f"Approve? {node_input}", response_schema=str)
    wf_yield = Workflow(name="hy", edges=[("START", draft, approve_yield, execute)])
    _, _, events, _ = await run(wf_yield, user_msg("order-20"))
    print(f"hitl with yield instead of return: function calls {[fc.name for e in events for fc in e.get_function_calls()]}")

    wf, runner, session, call = await pause(str, "order-18")
    _, _, events, error = await run(wf, reply(call, {"result": 42}), runner, session)
    print(f"hitl reply 42 sent as a number, response_schema=str: {status(error)}, execute ran {counts['execute']} time(s)")

    for text in ("42", "true", "042"):
        wf, runner, session, call = await pause(str, f"order-{text}")
        _, _, events, error = await run(wf, reply(call, {"result": text}), runner, session)
        print(f"hitl reply typed as the text {text}, response_schema=str: {status(error)}, "
              f"execute ran {counts['execute']} time(s), outputs {[e.output for e in events]}")

    wf, runner, session, call = await pause(None, "order-19")
    _, _, events, error = await run(wf, reply(call, {"result": 42}), runner, session)
    print(f"hitl reply 42 sent as a number, no response_schema: {status(error)}, outputs {[e.output for e in events]}")

async def warm_up():          # first run pays one-time import costs; keep them out of the timings
    await run(Workflow(name="warm", edges=[("START", FunctionNode(func=lambda node_input: "ok", name="ok"))]))

CHECKS = {"retry": retry, "scope": scope, "timeout": timeout, "route": route, "fanout": fanout, "hitl": hitl}
async def main():
    await warm_up()
    for name in sys.argv[1:] or CHECKS:
        await CHECKS[name]()
asyncio.run(main())
حدود هذه الاختبارات
تغطي هذه الفحوصات عقد الدوال (function nodes) ووقت التشغيل المحيط بها في حزمة Python، على جهاز sandbox واحد، مع مدد زمنية فعلية واستخدام time.sleep لتمثيل العمليات التي تسبب حظرًا (blocking work). معظم خلايا التوقيت تأتي من تشغيل واحد لكل مترجم (interpreter)، وأرقام الـ jitter تأتي من دفعات مكونة من 20 تشغيلًا. لم أختبر عقد وكلاء LLM، أو عقد الأدوات، أو سير العمل الديناميكي، أو خدمات الجلسات المستمرة، أو المشغلات المنشورة (deployed runners)، أو SDKs الخاصة بـ Go أو TypeScript، أو Python 3.14، أو الاستئناف بعد الانهيار، أو بعد إعادة التشغيل أو في منتصف عملية إعادة المحاولة. هناك ملاحظة TODO في _node_runner.py تقول إن إعادة محاولة فشل العقد الديناميكية سيتم النظر فيها لاحقًا: في الإصدار 2.10.0، عندما يفشل الابن الديناميكي للعقدة (الذي يبدأ بـ ctx.run_node) وينتقل DynamicNodeFailError__ الناتج خارج العقدة المستدعية، فإن مشغل العقدة لا يعيد محاولة تشغيل العقدة المستدعية، حتى لو كانت exceptions غير محددة.6 تعتمد نتيجة المهلة (timeout) على ما تفعله العقدة بعد الاستدعاء الحاجز وعلى المترجم، لذا اختبر عقدتك الحقيقية على الإصدار الذي تنشره. سقف الـ 30 ثانية يأتي من قراءة صيغة التأخير، وليس من الملاحظة.
الخلاصة
في هذه الاختبارات، عمل التوجيه، والتوزيع (fan-out)، وإعادة المحاولات، والتوقفات البشرية بشكل صحيح، وجاءت المفاجآت من كيفية تفاعلها مع حلقة الأحداث (event loop) ومع الإعدادات الافتراضية: فترات انتظار إعادة المحاولة العشوائية (jittered retry waits)، والمهلات الزمنية (timeouts) التي لا يمكنها مقاطعة الكود الذي يتسبب في حظر التنفيذ (blocking code) ثم تتصرف بشكل مختلف بناءً على ما تفعله العقدة تالياً وعلى إصدار Python، والمسارات غير المتطابقة التي لا تطلق أي خطأ وتترك في أقصى الحالات سطراً في السجل. اكتب عقدًا تترك المجال لحلقة الأحداث، وحدد سياسة إعادة المحاولة صراحةً، وامنح كل موجه DEFAULT_ROUTE، وحدد response_schema لكل توقف بشري، وقم بتشغيل السكريبت أعلاه على الرسم البياني الخاص بك وإصدار Python الخاص بك.
Footnotes
-
Release v2.0.0 — google/adk-python on GitHub, fetched 2026-09-29 (release v2.0.0, published May 19). ↩ ↩2
-
Welcome to ADK 2.0 — Agent Development Kit documentation, fetched 2026-09-29 (Python 2.0 GA May 19, 2026; Go 2.0 GA June 30, 2026; TypeScript 2.0 GA August 21, 2026; the three main features; the exception-handling migration notes). ↩ ↩2 ↩3 ↩4
-
google-adk 2.10.0 — PyPI, fetched 2026-09-29 ("Released: Sep 25, 2026"; "Requires: Python >=3.10"), and Release v2.10.0 — google/adk-python on GitHub (published September 25; the changelog heading is dated 2026-09-24). ↩ ↩2 ↩3
-
Python quickstart — ADK documentation, fetched 2026-09-29 ("Python 3.10 or later"). ↩ ↩2
-
Why we built ADK 2.0 — Google Developers Blog, published July 1, 2026, fetched 2026-09-29. ↩
-
google-adk2.10.0 package source, installed from PyPI and read on 2026-09-29:google/adk/workflow/_retry_config.py(documented defaults),workflow/utils/_retry_utils.py(attempt limit, name-based exception matching, delay and jitter),workflow/_errors.py(NodeTimeoutErrorbase class),workflow/_node_runner.py(asyncio.wait_fortimeout, error events, retry warning, per-run attempt count, dynamic-node TODO),workflow/_function_node.py(sync functions called inline,Nonereturns and state events,rerun_on_resumedefault),workflow/_base_node.py(timeoutandretry_configdocstrings),workflow/_graph.py(edge matching and the unmatched-route warning),workflow/_join_node.py(JoinNodedocstring),workflow/_workflow.py(no retry logic),agents/invocation_context.py(event hand-off to the runner),agents/context.py(run_node),workflow/_node_runner_utils.py(the runner drives the root node through aNodeRunner, so a top-levelWorkflow'sretry_configapplies),workflow/_dynamic_node_scheduler.py(DynamicNodeFailErrorraised when arun_nodechild fails) andworkflow/utils/_rehydration_utils.py(JSON-parsing of{"result": ...}text). Therequests.exceptions.ConnectionErrorclass hierarchy was checked inrequests2.34.2, installed as a google-adk dependency. ↩ ↩2 ↩3 ↩4 ↩5 ↩6 ↩7 ↩8 ↩9 ↩10 ↩11 ↩12 ↩13 ↩14 ↩15 ↩16 ↩17 ↩18 ↩19 ↩20 ↩21 -
Python standard library
asyncio.wait_forsource, inspected withinspect.getsourcein Python 3.10.20, 3.11.15, 3.12.3 and 3.13.13 on 2026-09-29. ↩ -
Graph routes — ADK documentation, fetched 2026-09-29. ↩ ↩2
-
Human input — ADK documentation, fetched 2026-09-29. ↩ ↩2 ↩3 ↩4
-
Resume Agents — ADK documentation, fetched 2026-09-29. ↩