نماذج اتخاذ القرار بالذكاء الاصطناعي: Jev وLaya وClef والمزيد
٧ أكتوبر ٢٠٢٦
تجيب نماذج اتخاذ القرار بالذكاء الاصطناعي على أسئلة محددة النوع، مثل "أي فريق؟" أو "ما مدى الاستعجال؟" أو "نعم أم لا؟"، من خلال إعطاء احتمالية لكل إجابة بدلاً من كتابة نص.
أطلقت TypeSafe AI على هذه الفئة اسم "نماذج System One" عندما أطلقت Jev في 15 سبتمبر 2026.1 وفي غضون ثلاثة أسابيع، حذت Cloudflare و Liquid AI و OpenAI والعديد من المشاريع مفتوحة المصدر حذوها.
The Agentic Edge: وكلاء الذكاء الاصطناعي والأتمتة، شرح مخصص للأشخاص الذين يتخذون القرارات ويمولون وينفذون.
ملخص
تم بناء نماذج اتخاذ القرار من أجل الأحكام الصغيرة والمتكررة داخل عملية تجارية: مثل توجيه تذكرة دعم، أو تقييم عميل محتمل، أو الموافقة على فاتورة. لقد صُممت لتكون سريعة ورخيصة، وهي تعيد رقم ثقة يمكن لأنظمتك اتخاذ إجراء بناءً عليه.
يمكنك تجربة عدة نماذج مجانًا اليوم، بما في ذلك النماذج المفتوحة على Ollama. هناك اختبار معياري مستقل حديث مشجع ولكن نتائجه مختلطة: حيث لا يزال بإمكان مصنف صغير تم تدريبه على تسمياتك الخاصة أن يضاهي هذه النماذج أو يتفوق عليها.2
ماذا حدث
15 سبتمبر 2026. أصدرت TypeSafe AI، التي أسسها الباحث السابق في OpenAI ديوجو ألميدا، نموذج Jev في "وصول مبكر". ويذكر منشور الإطلاق أن Jev "يتخلى عن توليد النصوص" ويعيد "قرارات احتمالية محددة النوع".1
29 سبتمبر. أعلنت OpenAI عن Decisions API في DevDay. ويذكر ملخص مجتمع مطوري OpenAI لـ DevDay أنه في "معاينة محدودة" و"يستخدم Luna لتصنيف المدخلات، أو توجيه الطلبات، أو اختيار إجراء من إجابات محددة مسبقًا".3
في نفس الأسبوع. أصدرت Liquid AI نموذج d1، وهو نموذج اتخاذ قرار مستضاف يعمل مع مجموعات برمجيات TypeSafe ويحتوي على فئة مجانية للنصوص فقط، d1:free.4
1 أكتوبر. أصدرت Cloudflare نموذجي Clef و Clef-Flash، وهما نموذجا اتخاذ قرار مفتوحا المصدر بموجب رخصة Apache 2.0، ومستضافان على منصة Workers AI الخاصة بها.5
في هذه الأثناء، انفجر المجال مفتوح المصدر. تتبعت قائمة مجتمعية، awesome-system-one، 27 نموذجًا لاتخاذ القرار اعتبارًا من 2 أكتوبر 2026. وتحذر القائمة من أن "الاختبارات المعيارية الخاصة بها يتم الإبلاغ عنها ذاتيًا وغير قابلة للمقارنة بشكل مباشر".6
ما هو نموذج اتخاذ القرار، بلغة بسيطة؟
يقوم نموذج اللغة الكبير (LLM)، مثل ChatGPT، بكتابة نصوص ليقرأها البشر. أما نموذج اتخاذ القرار فلا يكتب نصوصًا أبدًا. أنت تعطيه مدخلات، مثل تذكرة دعم، ومجموعة من الأسئلة مع خيارات إجابة ثابتة.7
ويقوم النموذج بإعادة الإجابة المختارة بالإضافة إلى الاحتمالية. أنواع الأسئلة الثلاثة في TypeSafe هي: الاختيار (Choice - اختر خيارًا)، والتقييم (Score - التقييم على مقياس)، و Noul (هل هذه العبارة صحيحة؟).7
لماذا يهم رقم الثقة: يمكن لبرنامجك أن يتصرف من تلقاء نفسه عندما يكون النموذج واثقاً، ويرسل الحالة إلى شخص عندما لا يكون كذلك. تصف TypeSafe هذا بأنه تحديد "عتبات متى يتصرف النموذج بشكل مستقل ومتى يطلب المراجعة."8
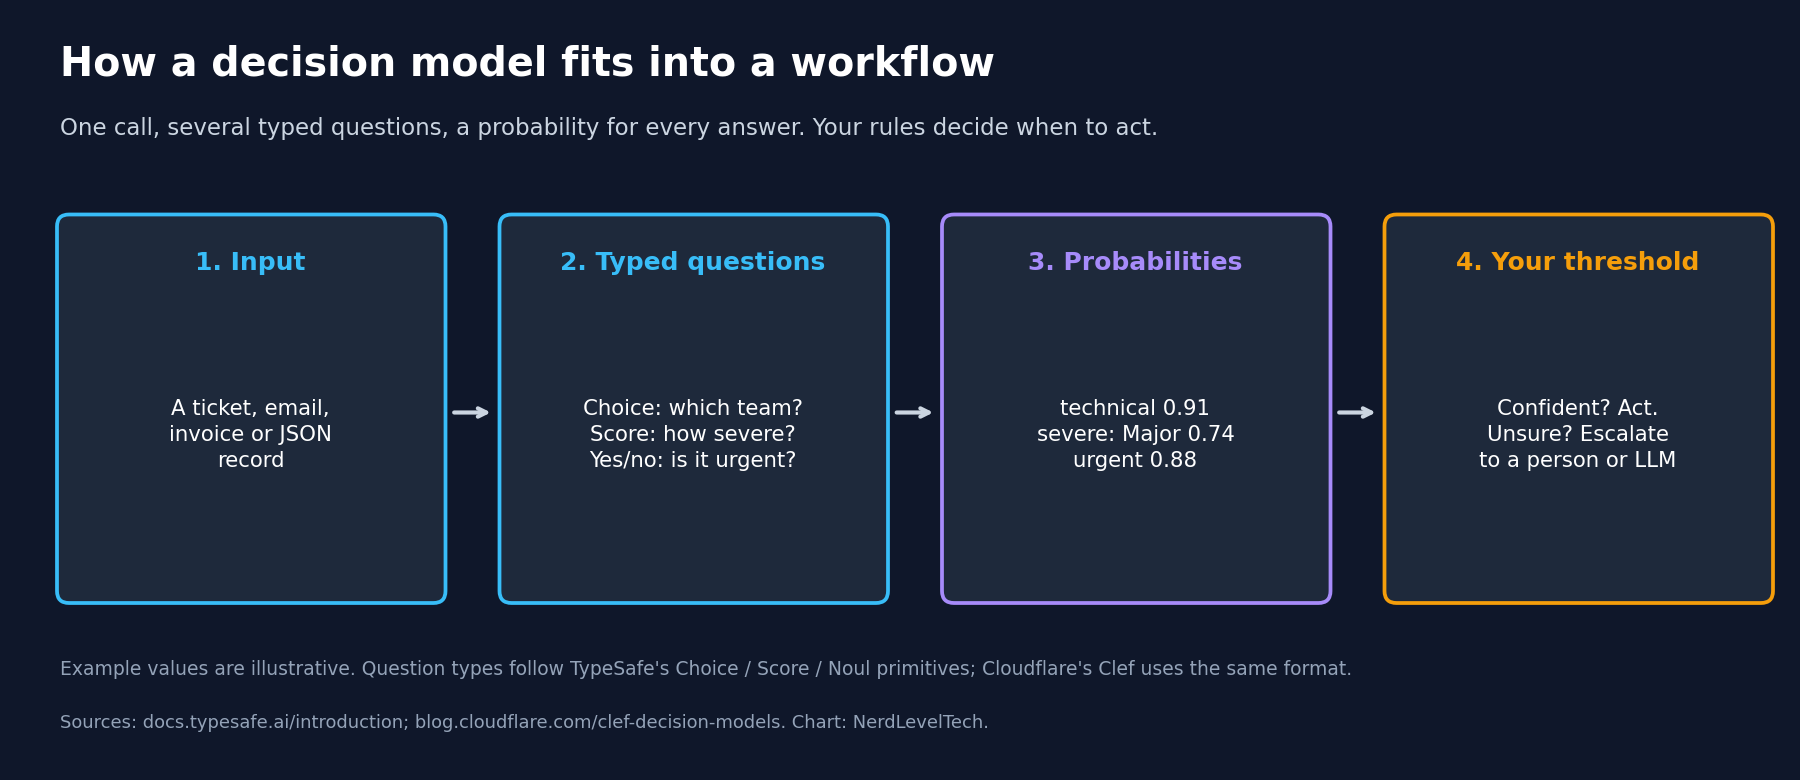
الشكل 1: كيف يتناسب نموذج القرار في سير العمل. القيم المذكورة هي لأغراض توضيحية. تم بناؤه من وثائق TypeSafe ومنشور Clef الخاص بـ Cloudflare.
مشهد نماذج اتخاذ القرار
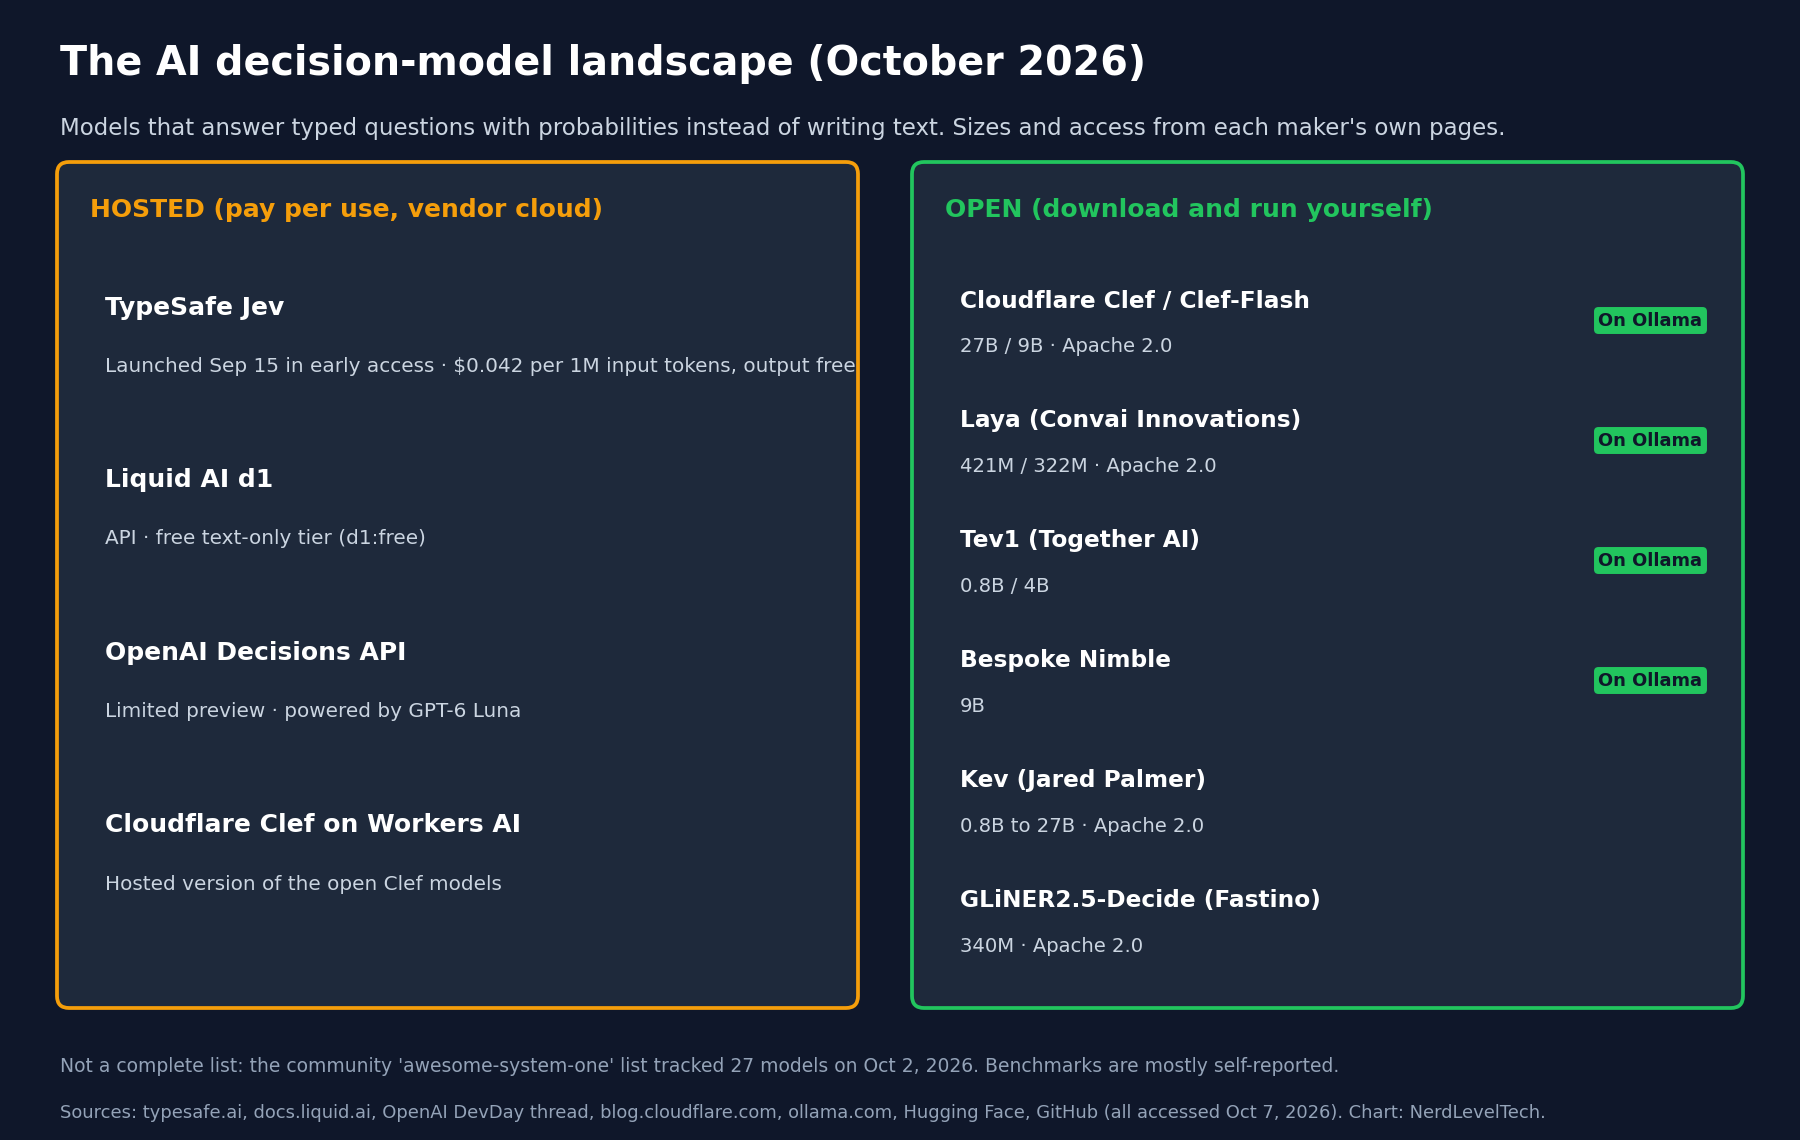
الشكل 2: النماذج الرئيسية حسب نوع الوصول. هذه ليست قائمة كاملة.
النماذج المستضافة (الدفع حسب الاستخدام)
- TypeSafe Jev (الوثائق، قائمة OpenRouter). النموذج الذي بدأ هذه الفئة. السعر: 0.042 دولار لكل مليون توكن مدخل، مع مخرجات "مجانية".1 لم تنشر TypeSafe العمود الفقري لـ Jev أو بنيته التفصيلية.2
- Liquid AI d1 (قائمة OpenRouter). يستخدم نفس تنسيق الأسئلة مثل Jev، مع نسخة مجانية للنصوص فقط ونسخة مدفوعة تقبل الصور.4 تدرجه OpenRouter بسعر 0.04 دولار لكل مليون توكن مدخل.9
- OpenAI Decisions API. معاينة محدودة، مبني على GPT-6 Luna. لم تنشر OpenAI الأسعار حتى 7 أكتوبر 2026.36
- Cloudflare Clef on Workers AI. نسخ مستضافة من نماذج Cloudflare المفتوحة. تقول Cloudflare أن Clef يقرأ الصور، على عكس Jev، ولديه نافذة سياق تبلغ 64 ألفاً مقابل 32 ألفاً لـ Jev.5
النماذج المفتوحة التي يمكنك تحميلها
- Cloudflare Clef (27 مليار بارامتر) و Clef-Flash (9 مليار). ترخيص Apache 2.0. متاح على Ollama باسم clef و clef-flash.510
- Laya من Convai Innovations (GitHub). صغير جداً: 421 مليون parameter للغة الإنجليزية و322 مليون لأكثر من 100 لغة. متاح على Ollama باسم laya.11
- Tev1 من Together AI. موديل تجريبي بحجم 4B؛ رخصة الأوزان الخاصة به "لا تزال قيد اللمسات الأخيرة". متاح على Ollama باسم tev1.1012
- Bespoke Nimble من Bespoke Labs (9B). متاح على Ollama باسم nimble.10
- Kev من Jared Palmer. أحجام تتراوح من 0.8B إلى 27B، برخصة Apache 2.0، مصمم ليعمل مع مجموعة برمجيات TypeSafe بدون تغييرات.13
- GLiNER2.5-Decide من Fastino. مصنف (classifier) بـ 340 مليون parameter لتوجيه النوايا (intent routing)، وتحليل المشاعر والفرز، برخصة Apache 2.0.14
الـ parameter، في سطر واحد: مقياس تقريبي لحجم الموديل. الموديلات الأصغر تكون أرخص وأسرع في التشغيل، وأصغر نسخة من Kev بحجم 0.8B "تعمل على لاب توب".13
أين تشغلها محلياً
Ollama، وهو تطبيق لتشغيل موديلات الذكاء الاصطناعي على جهازك الخاص، يحتوي الآن على فئة موديلات "Decision". في 7 أكتوبر 2026، كانت هذه الفئة تضم خمسة موديلات: clef-flash، وclef، وlaya، وtev1، وnimble. كما تظهر في البحث تحميلات من المجتمع بأسماء مشابهة.10
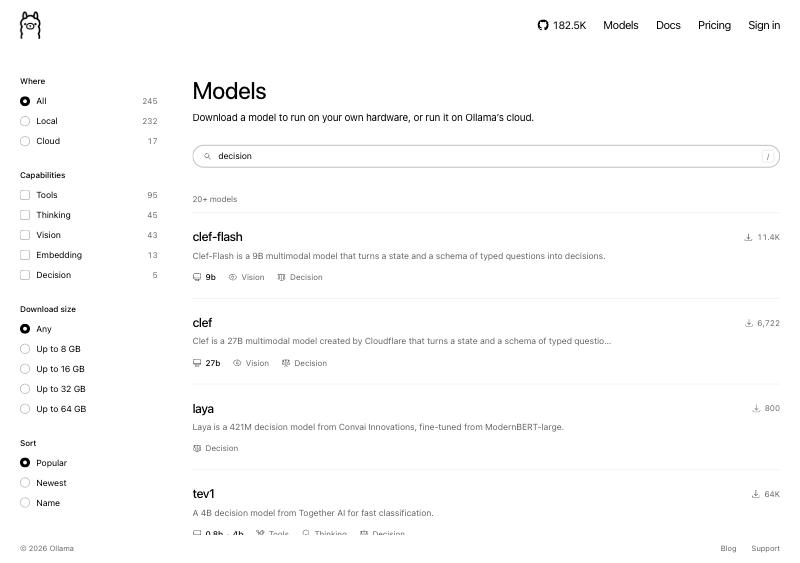
لقطة شاشة: بحث الموديلات في ollama.com، تم التقاطها في 7 أكتوبر 2026.
كل موديل منها يتم تحميله بأمر واحد في Ollama. تحقق من صفحة الموديل لمعرفة الحد الأدنى للإصدار: صفحة Laya تقول إنها "تتطلب Ollama 0.40.0 أو إصداراً أحدث".11 هناك أيضاً Ollaya، وهو مشغل مفتوح المصدر منفصل لموديلات اتخاذ القرار (decision models) يذكر أنه "غير تابع لـ Ollama أو TypeSafe ولا يحظى بتوصية منهما".15
ما الذي تظهره اختبارات الأداء (benchmarks) فعلياً
هناك نوعان من الأدلة: اختبارات أداء الموردين والأبحاث المستقلة. يستخدم هذا المنشور دراسة مستقلة حديثة واحدة. ولا يتفق النوعان دائماً.
ادعاءات الموردين
تدعي الصفحة الرئيسية لشركة TypeSafe أن Jev "أسرع بـ 193.6 مرة، وأرخص بـ 444.6 مرة" من نماذج LLMs بناءً على اختبارات سير العمل الخاصة بها.8 ويضيف منشور الإطلاق تنبيهاً بأنهم "يتوقعون أن تكون هذه النتائج في الحد الأعلى من المكاسب الواقعية"، وأن الاختبارات تم بناؤها بواسطة فريقهم الخاص، "لذا قد يكون هناك بعض الانحياز".1
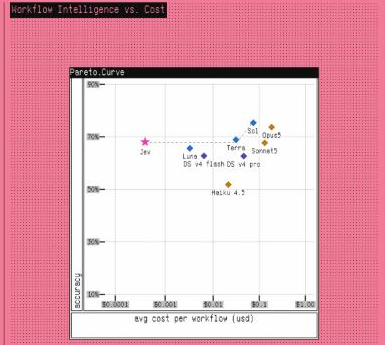
لقطة شاشة: الصفحة الرئيسية لـ typesafe.ai، تم التقاطها في 7 أكتوبر 2026. نتائج مُبلغ عنها من المورد.
نشرت Cloudflare مقارنتها الخاصة. وفي جدولها، يتفوق Clef على Jev في معظم الاختبارات المرجعية العشرة التي أدرجتها، ويبلغ متوسط زمن الاستجابة لـ Clef-Flash حوالي 38.8 مللي ثانية مقابل 524.1 لـ Jev.5
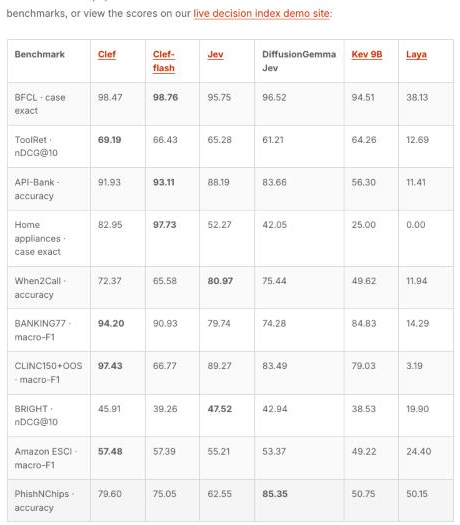
لقطة شاشة: مدونة Cloudflare، تم التقاطها في 7 أكتوبر 2026. نتائج مُبلغ عنها من المورد، تم قياسها بواسطة Cloudflare.
اختبار مرجعي مستقل
في 29 سبتمبر 2026، نشر الباحثان Amir Rafe و Subasish Das دراسة على arXiv تقارن بين ثماني نقاط تفتيش لنماذج اتخاذ القرار، بما في ذلك Jev، مع مصنفات مدربة ونماذج LLMs عامة. وهي نسخة أولية (preprint)، ولا تذكر صفحتها على arXiv أي منشور مراجع من قبل الأقران حتى الآن.2
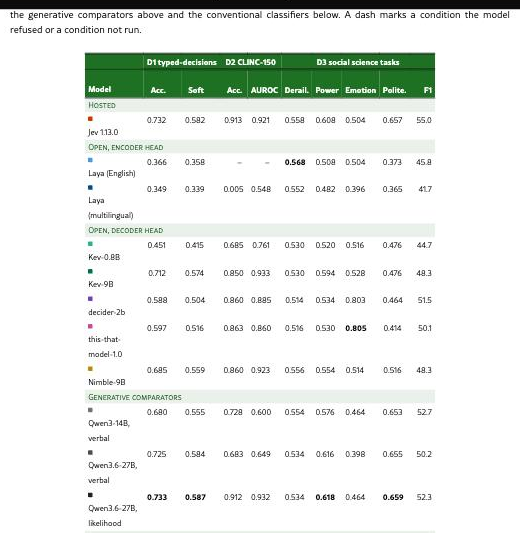
لقطة شاشة: arXiv 2610.00346، الجدول 5 (الدقة)، تم التقاطها في 7 أكتوبر 2026.
هناك أربع نتائج تهم القراء من قطاع الأعمال:2
- تصدر Jev نماذج اتخاذ القرار من حيث الدقة. حيث سجل 0.732 في مجموعة سير عمل typed-decisions و 0.913 في مجموعة نوايا CLINC-150.
- لا يزال من الصعب التغلب على المصنف المدرب الصغير. حيث سجل مصنف BGE-small المدرب على تسميات كل مهمة 0.702 و 0.948. واستنتج المؤلفون أن "المصنفات المدربة الصغيرة هي الأكثر دقة في تحديد النوايا".
- التسميات مهمة. "تبديل (نعم) و (لا) يقلب 50.5 إجابة لكل مائة بالنسبة لـ Jev". طريقة تسمية خيارات الإجابة يمكن أن تغير الإجابة نفسها.
- إعداد مكون من مرحلتين يمكن أن يخفض الفاتورة إلى أقل من النصف. مرحلة أولى مدربة على النوايا تقوم بتصعيد الحالات الصعبة إلى Jev "تطابق دقته بتكلفة تبلغ 0.43 من تكلفته" وفقاً لافتراض الدراسة باستخدام وحدة GPU مستغلة بالكامل.
قاست الدراسة نفسها السرعة والتكلفة. أجاب Jev في متوسط زمن قدره 138 مللي ثانية، بتكلفة 0.0079 دولار لكل ألف قرار. أما نموذج Laya المفتوح متعدد اللغات فقد استغرق 32 مللي ثانية، بتكلفة 0.0009 دولار لكل ألف، على وحدة GPU سحابية مستأجرة.2
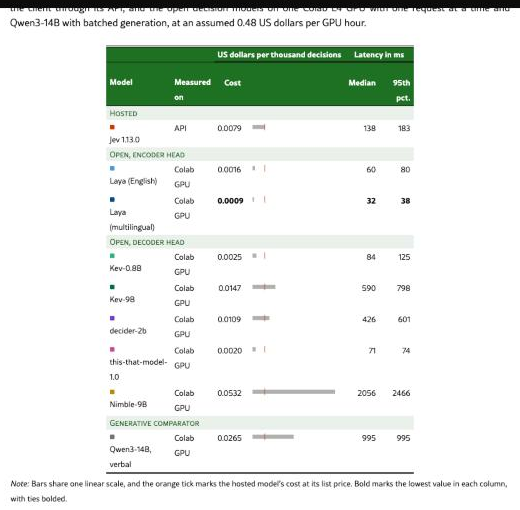
لقطة شاشة: arXiv 2610.00346، الجدول 8 (التكلفة وزمن الاستجابة)، تم التقاطها في 7 أكتوبر 2026.
لاحظ الفجوة بين المصادر: سجلت Laya درجات منخفضة جداً في جدول Cloudflare و0.366 في القرارات المكتوبة في الدراسة المستقلة.52 كما تذكر بطاقة النموذج الخاصة بها مهاماً مختلفة.11 وهذا هو السبب الأكثر وضوحاً للاختبار باستخدام بياناتك الخاصة.
حالات الاستخدام حسب الدور
هذه هي اقتراحاتنا، المبنية على الأمثلة التي يقدمها الموردون. تعرض Cloudflare تذكرة دعم يتم فحصها لمعرفة مدى استعجالها، وتوجيهها إلى فريق، وتقييم مدى خطورتها، وفاتورة يتم تصنيفها كمدفوعة أو متأخرة أو مسودة.516 بينما تدرج TypeSafe التوجيه، والتقييم، و"map-reducing عبر البيانات الضخمة"، وفحص مخرجات LLM، بما في ذلك اكتشاف محاولات الاختراق (jailbreaks).1
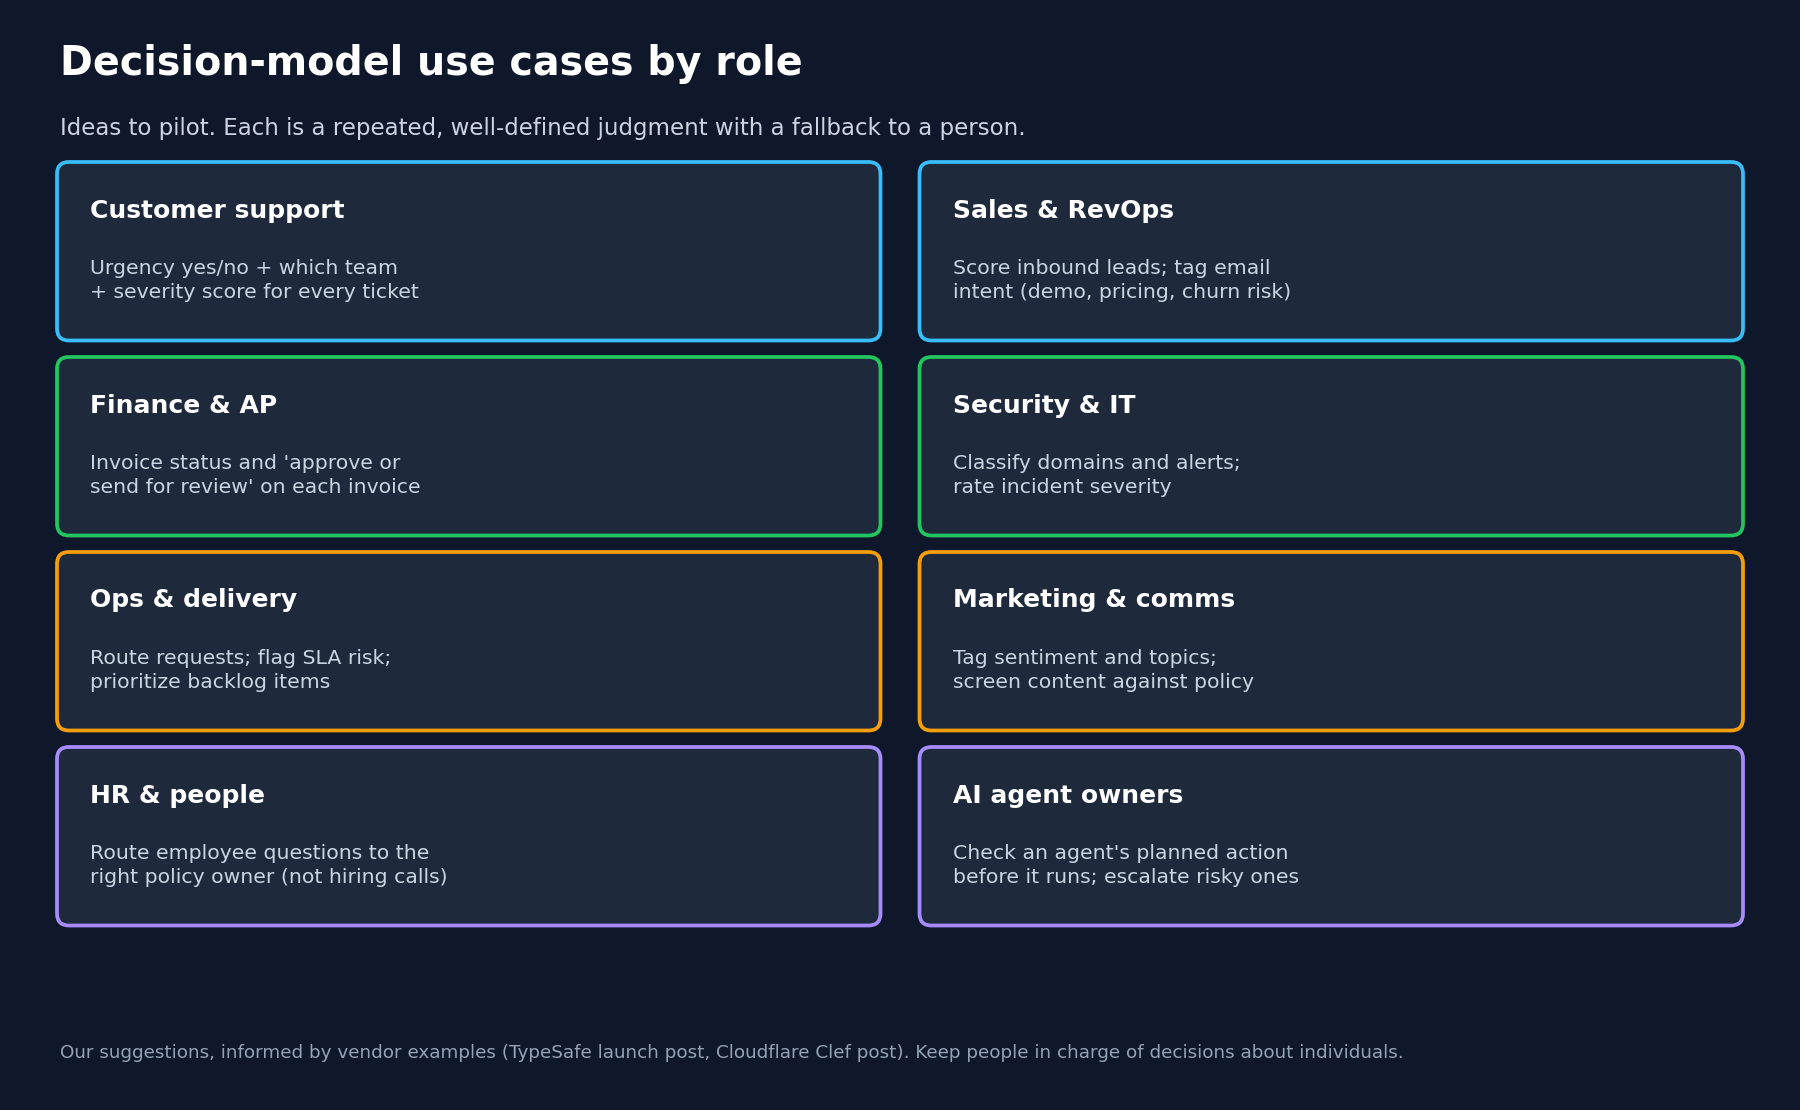
الشكل 3: حالات الاستخدام حسب الدور. اقتراحاتنا، المستوحاة من أمثلة الموردين.
- دعم العملاء. اطرح ثلاثة أسئلة على كل تذكرة: هل هي عاجلة، أي فريق يملكها، وما مدى خطورتها؟ قم بتوجيه التذاكر التي يكون النموذج واثقاً منها تلقائياً.
- المبيعات وعمليات الإيرادات (RevOps). تقييم العملاء المحتملين الواردين وتصنيف هدف كل بريد إلكتروني، مثل طلب عرض توضيحي (demo)، أو سؤال عن الأسعار، أو مخاطر فقدان العميل (churn risk).
- المالية والحسابات الدائنة. تصنيف حالة الفاتورة واتخاذ قرار بـ "الموافقة" أو "الإرسال للمراجعة". مع إبقاء تدخل بشري في أي شيء يتجاوز حداً مالياً معيناً.
- الأمن وتكنولوجيا المعلومات. تقول Cloudflare إنها كانت تختبر Clef مع فريق استخبارات التهديدات الخاص بها لتصنيف نطاقات المواقع الإلكترونية. استغرق Clef زمن 2.2 ثانية مقابل 4.7 ثانية لـ gpt-oss-120b في نفس سير العمل.5
- العمليات والتنفيذ. توجيه الطلبات الداخلية، وتحديد العمل المعرض لخطر تفويت الموعد النهائي، وتقييم عناصر قائمة الأعمال المتراكمة (backlog) حسب الأولوية.
- التسويق والاتصالات. تصنيف المشاعر والمواضيع عبر المراجعات أو منشورات التواصل الاجتماعي، وفحص المسودات مقابل سياسة المحتوى الخاصة بك.
- الموارد البشرية وفرق شؤون الموظفين. توجيه أسئلة الموظفين إلى صاحب السياسة المختص. لا تستخدم هذه النماذج في قرارات التوظيف أو تقييم الأداء للأفراد.
- مالكو وكلاء الذكاء الاصطناعي. قبل أن يتخذ وكيل الذكاء الاصطناعي إجراءً ما، اسأل نموذج القرار عما إذا كان الإجراء يتوافق مع سياستك، وقم بتصعيد الأمر عندما يكون النموذج غير متأكد.
لماذا يهم هذا الأمر
للمديرين التنفيذيين
قراءتنا للموقف: غالباً ما تستخدم الفرق نموذجاً ضخماً ومكلفاً لإصدار أحكام بسيطة بـ "نعم" أو "لا". تهدف نماذج القرار إلى جعل هذه الأحكام بنداً منخفض التكلفة. وقد يكون الربح الأكبر هو التحكم، لأن كل قرار يأتي مع درجة ثقة يمكنك مراجعتها.
لمديري المنتجات
ابحث عما تسميه TypeSafe "جمل if الذكية" في منتجك: الأماكن التي يتخذ فيها الكود حكماً غامضاً جداً بحيث لا تكفيه القواعد الثابتة.1 توصي وثائق TypeSafe بتقسيم الحكم الكبير إلى أسئلة صغيرة ودمج الإجابات في الكود.7
لقادة المشاريع والتنفيذ
هذه النماذج سهلة التجربة. اختر قراراً واحداً يتكرر بكثافة، وقم بتشغيل نموذج بجانب عمليتك الحالية لمدة أسبوعين، ثم قارن بينهما. حدد عتبة للثقة وأرسل كل ما يقل عنها إلى شخص بشري.
ماذا تفعل هذا الأسبوع
- قائمة بقراراتك المتكررة. ابحث عن ثلاثة أحكام يتخذها فريقك مئات المرات أسبوعياً، مثل توجيه التذاكر، أو تقييم العملاء المحتملين (lead scoring)، أو مراجعة الفواتير.
- جمع 200 مثال سابق مع الإجابة الصحيحة لأحد هذه القرارات. سيصبح هذا هو اختبارك الخاص.
- تجربة خيار مجاني. اطلب من زميل تقني اختبار نموذج مفتوح من Ollama أو الفئة المجانية من Liquid d1 مقابل أمثلتك.
- المقارنة مع مصنف بسيط (classifier). تظهر دراسة مستقلة أن نموذجاً صغيراً مدرباً يمكن أن يضاهي هذه النماذج في المهام المحددة.2
- تحديد العتبة الخاصة بك. اتفق على مستوى الثقة الذي يسمح للنظام بالتصرف بمفرده، ومن سيقوم بمراجعة البقية.
أسئلة تطرحها على فريقك أو المورد
- ما هي الدقة التي يصل إليها النموذج في أمثلتنا نحن، وليس في الاختبارات العامة؟
- كم مرة يغير إجابته إذا أعدنا صياغة السؤال؟
- ماذا يحدث للمدخلات التي لا تتناسب مع أي من الخيارات؟
- أين يتم معالجة البيانات، وهل تُستخدم في التدريب؟
- ما هي التكلفة لكل ألف قرار بناءً على حجم عملنا؟
- هل يمكننا تشغيله بأنفسنا، وما هي الرخصة؟
- من يراجع الحالات ذات الثقة المنخفضة، وبأي سرعة؟
المخاطر وما لا نعرفه بعد
معظم الاختبارات المرجعية (Benchmarks) يتم الإبلاغ عنها ذاتياً. يشير متتبع المجتمع إلى أن الاختبارات المرجعية للموردين "غير قابلة للمقارنة بشكل مباشر".6 لا تزال الأبحاث المستقلة في بدايتها: الدراسة المذكورة هنا هي نسخة أولية (preprint)، وبحسب مراجعتها الخاصة، فإن معظم الدراسات السابقة غطت نماذج أو ظروف اختبار أقل.2
"لا يمكنه الهلوسة" لا تعني "لا يمكن أن يخطئ". تقول TypeSafe أن Jev "لا يمكنه الهلوسة" لأنه يجيب دائماً بالتنسيق المسموح به.1 لكنه لا يزال بإمكانه اختيار الخيار الخاطئ، وقد وجدت الدراسة المستقلة أنه عند عتبة محددة لمخاطرة بنسبة 5%، لا يزال Jev يقبل 0.310 من الطلبات الخارجة عن النطاق.2
منتجات أولية. تم إطلاق Jev في مرحلة الوصول المبكر، وAPI من OpenAI في معاينة محدودة.13 قد تتغير الأسعار: تقول TypeSafe "لا يمكننا إثبات أنها ليست مدعومة".1
القرارات المتعلقة بالأشخاص. القرارات المؤتمتة بشأن الموظفين أو ائتمان العملاء أو المجالات المماثلة قد تكون خاضعة للقوانين. اجعل هناك شخصاً مسؤولاً. هذه ليست استشارة قانونية.
وجهة نظرنا: هذا واحد من أكثر اتجاهات الذكاء الاصطناعي العملية لهذا العام لفرق الأعمال. ابدأ بقرار واحد محدد وعالي الكثافة وقم بقياسه.
الخلاصة
تحول نماذج القرار هدف "استخدام الذكاء الاصطناعي" الغامض إلى شيء قابل للقياس: قرار واحد، درجة ثقة واحدة، حد واحد. هناك العديد من النماذج المتاحة للتجربة مجاناً اليوم.
اختبرها على أمثلتك الخاصة قبل الوثوق بأي معيار قياسي، وأبقِ عنصراً بشرياً لمراجعة الحالات التي لا يكون النموذج متأكداً منها.
قراءات ذات صلة
- Salesforce ستقوم بحساب مكالمات وكلاء الذكاء الاصطناعي: ماذا تفعل يشرح لماذا أصبح عدد المكالمات التي يجريها وكلاؤك بنداً من بنود التكلفة.
- JEPA ونماذج العالم: مراجعة للضجيج المثار للقادة يغطي توجهاً مختلفاً في الذكاء الاصطناعي لا يزال في مرحلة البحث.
- خوادم MCP للمؤسسات: طبقة إجراءات الوكلاء لعام 2026 يغطي كيفية اتصال الوكلاء بأنظمة الأعمال التي تغذيها هذه القرارات.
ليست نصيحة مالية أو قانونية.
المراجع
Footnotes
-
Introducing System One Models & Jev — Diogo Almeida, TypeSafe AI, September 15, 2026. Source for the launch date, early access, pricing, "gives up string generation", "can't hallucinate", the workflow-eval caveats, use cases and the subsidy statement. ↩ ↩2 ↩3 ↩4 ↩5 ↩6 ↩7 ↩8 ↩9 ↩10 ↩11
-
Benchmarking System One decision models against trained classifiers and language models for automated decision gates — Amir Rafe and Subasish Das, arXiv preprint 2610.00346, submitted September 29, 2026. Source for Tables 5 and 8, the accuracy, cost and latency figures, the yes/no swap result, the out-of-scope result and the cascade result. ↩ ↩2 ↩3 ↩4 ↩5 ↩6 ↩7 ↩8 ↩9 ↩10
-
DevDay 2026 announcements and developer resources — OpenAI Developer Community, September 29, 2026. Source for the Decisions API's limited preview and description. ↩ ↩2 ↩3
-
Decision models — Liquid AI documentation, accessed October 7, 2026. Source for d1, d1:free and TypeSafe SDK compatibility. ↩ ↩2
-
Introducing Clef: our open-source decision models, and new RL fine-tuning platform — Michelle Chen, Alex Reneau and Kevin Flansburg, Cloudflare Blog, October 1, 2026. Source for Clef and Clef-Flash, Apache 2.0, Workers AI, the vision and context comparison, the benchmark and latency table, the support-ticket example and the threat-intelligence example. ↩ ↩2 ↩3 ↩4 ↩5 ↩6 ↩7 ↩8
-
awesome-system-one — community-maintained list, last checked October 2, 2026. Source for the count of 27 models, the self-reported benchmark warning, and the note that OpenAI's price was not yet published. ↩ ↩2 ↩3 ↩4
-
Introduction — TypeSafe AI documentation, accessed October 7, 2026. Source for the Choice, Score and Noul question types and the advice to decompose questions. ↩ ↩2 ↩3
-
TypeSafe AI homepage — accessed October 7, 2026. Source for "193.6x Faster, 444.6x Cheaper", the threshold quote and the Pareto chart screenshot. ↩ ↩2
-
Liquid AI: d1 — OpenRouter, accessed October 7, 2026. Source for the d1 price listing. ↩
-
Ollama Decision models, Ollama search: decision and the clef, clef-flash, tev1 and nimble pages — Ollama, accessed October 7, 2026. Source for the Decision category, the five models and their sizes. ↩ ↩2 ↩3 ↩4 ↩5
-
convaiinnovations/laya — Hugging Face model card, and laya on Ollama, accessed October 7, 2026. Source for the sizes, languages and the Ollama version requirement. ↩ ↩2 ↩3 ↩4
-
Tev1-4B-experimental — Together AI on Hugging Face, accessed October 7, 2026. Source for the base model and license status. ↩
-
Kev — Jared Palmer on GitHub, accessed October 7, 2026. Source for sizes, the "runs on a laptop" quote, license and TypeSafe SDK compatibility. ↩ ↩2
-
GLiNER2.5-Decide — Fastino on Hugging Face, accessed October 7, 2026. Source for the size, license and use cases. ↩
-
Ollaya — GitHub, accessed October 7, 2026. Source for the independence statement. ↩
-
Cloudflare/clef — Hugging Face model card, accessed October 7, 2026. Source for the invoice-status example. ↩